ollvm--混淆
这里用不知道哪里找到的ollvm17混淆,
https://github.com/DreamSoule/ollvm17
不算很new,主要用于研究一些好玩的
一些基础知识
关系支配树
定义:如果从函数入口到基本块 B 的所有路径都必须经过基本块 A,则称:A支配B
1
2
3
4
5
6
7
8
entry | v check / \ A B \ / merge
例如这里check就支配A,B和merge
clang 编译器的编译流程
clang是一种用llvm 作为后端的编译器
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
C/C++ 源代码 ↓ 预处理 ↓ 词法分析、语法分析、语义分析 ↓ Clang AST ↓ LLVM IR .ll ↓ LLVM 优化 / OLLVM 混淆 Pass ↓ 目标相关机器指令 ↓ 汇编或目标文件 .o ↓ 链接 ↓ 可执行文件或 .so
编译大致流程如上,我们这里主要研究IR层的内容
pass和new pass manager
有个叫opt的可执行文件,负责加载和管理pass.当然pass 的调用方式有很多种.等下再讲吧,没看明白.不过opt可以加载现成的elf文件,
我们可以写一个自己的pass然后用opt测试.
什么是pass
pass是对中间层IR代码进行处理的程序.
pass的处理根据颗粒度(似乎找不到更合适的描述了,就这么说吧)其实根据的是一个程序的不同细致层次
pass主要能够分析和改变一个IR
分析 Analysis :收集信息但不修改 IR,例如支配树、循环信息、别名分析。变换 Transform :修改 IR,例如常量折叠、内联、控制流平坦化、虚假控制流。
中间层的处理层次
依次往下
Module
Module:一个模块.其实就是一个cpp源文件生成出来的一个.ll
Call Graph Pass 主要是GCSCC
call Graph pass 操作的是调用图中的强连同分量(SCCS).
主要是操纵的函数之间调用的关系
构成一个强连同分量就是这里
比如一个程序如下
1
2
3
4
5
6
7
8
9
10
11
12
13
14
void C () {}void B () { C(); } void A () { B(); C(); } int main () { A(); }
这里的函数调用图是
1
2
3
4
5
6
7
8
9
10
main │ ▼ A ┌┴──────┐ ▼ ▼ B C │ ▼ C
这个函数调用图没有任何构成了一个非平凡的强连通调用图.那么我们就可以这么分
1
2
3
4
CGSCC 1 = {C} CGSCC 2 = {B} CGSCC 3 = {A} CGSCC 4 = {main}
那么什么是强连通调用图呢
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
void B () ;void D () ;void A () { B(); } void B () { A(); } void C () { D(); } void D () { C(); } int main () { A(); C(); }
调用图如下
1
2
3
SCC 1 = {A, B} SCC 2 = {C, D} SCC 3 = {main}
Functions Pass
一次处理一个函数.后面我们遇到的大多数都是操作的这里
loop pass
主要处理函数内的一个循环,他只特定处理循环内的内容
怎么编写编译pass
这里我们以两个pass作为示例.第一个优化过程中去掉没有实际意义的加零指令
这种操作一般是由于优化代码.我们可以写一个简单的pass
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 #include "llvm/ADT/SmallVector.h" #include "llvm/Config/llvm-config.h" #include "llvm/IR/Function.h" #include "llvm/IR/Instructions.h" #include "llvm/IR/PassManager.h" #include "llvm/IR/PatternMatch.h" #include "llvm/Passes/PassBuilder.h" #include "llvm/Passes/PassPlugin.h" #include "llvm/Support/raw_ostream.h" using namespace llvm; using namespace llvm::PatternMatch; namespace { class RemoveAddZeroPass : public PassInfoMixin<RemoveAddZeroPass> {public: PreservedAnalyses run (Function &F, FunctionAnalysisManager &AM) { if (F.isDeclaration()) return PreservedAnalyses::all(); SmallVector<Instruction *, 8 > ToErase; for (BasicBlock &BB : F) { for (Instruction &I : BB) { auto *BO = dyn_cast<BinaryOperator>(&I); if (!BO) continue ; if (BO->getOpcode() != Instruction::Add) continue ; Value *Replacement = nullptr; if (match(BO->getOperand(1 ), m_Zero())) { Replacement = BO->getOperand(0 ); } else if (match(BO->getOperand(0 ), m_Zero())) { Replacement = BO->getOperand(1 ); } if (!Replacement) continue ; BO->replaceAllUsesWith(Replacement); ToErase.push_back(BO); } } for (Instruction *I : ToErase) I->eraseFromParent(); if (ToErase.empty()) return PreservedAnalyses::all(); errs() << "[remove-add-zero] function " << F.getName() << ": removed " << ToErase.size() << " instruction(s)\n" ; return PreservedAnalyses::none(); } }; } extern "C" LLVM_ATTRIBUTE_WEAKPassPluginLibraryInfo llvmGetPassPluginInfo () { return { LLVM_PLUGIN_API_VERSION, "RemoveAddZeroPass" , LLVM_VERSION_STRING, [](PassBuilder &PB) { PB.registerPipelineParsingCallback( [](StringRef Name, FunctionPassManager &FPM, ArrayRef<PassBuilder::PipelineElement>) { if (Name == "remove-add-zero" ) { FPM.addPass(RemoveAddZeroPass()); return true ; } return false ; }); }}; }
这个结构比较简单.
我们可以一次解释一下顺带可以解释一些cpp上面的东西
1
2
class RemoveAddZeroPass : public PassInfoMixin<RemoveAddZeroPass>
这是new pass manager的写法.查询资料,这里是进行了一个CRTP:Curiously Recurring Template Pattern,奇异递归模板模式
即: 派生类把“自己”作为模板参数,传给基类,然后再继承这个基类。
似乎作用类似于虚函数?查找后发现可以简单介绍一下
动态多态和静态多态的概念后续我会在新开的cpp章节里面补充
动态多态:也叫运行时多态,一般利用虚函数和继承还有重写实现
静态动态:编译期多态,一般用模板,函数重载,泛型实现
具体后面讲cpp多态的时候再补充.这里passinfoMixin只是给信息的
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
template <typename DerivedT> struct PassInfoMixin { static StringRef name () static_assert (std::is_base_of<PassInfoMixin, DerivedT>::value, "Must pass the derived type as the template argument!" ); StringRef Name = getTypeName <DerivedT>(); Name.consume_front ("llvm::" ); return Name; } void printPipeline (raw_ostream &OS, function_ref<StringRef(StringRef)> MapClassName2PassName) StringRef ClassName = DerivedT::name (); auto PassName = MapClassName2PassName (ClassName); OS << PassName; } };
然后
1
2
PreservedAnalyses run (Function &F, FunctionAnalysisManager &AM)
run函数返回值PreservedAnalyses决定旧分析缓存
一般来说只要修改了IR 的内容,就return PreservedAnalyses::none();
表示所有的分析全部失效.如果后面是return PreservedAnalyses::all();则表示保留
1
2
3
4
5
6
Function &F 当前正在处理的函数 FunctionAnalysisManager &AM 函数级分析管理器
FunctionAnalysisManager
能够获取支配树,循环等内容,不过我看没怎么用到.先不多讲了
之后再创建一个vector保留要删除的地方
之后就是遍历函数的指令,然后再用dyn_cast判断指令的类型
使用 dyn_cast 判断指令类型
1 auto *BO = dyn_cast <BinaryOperator>(&I);
含义是:
1
2
如果 I 是 BinaryOperator,返回对应指针; 否则返回 nullptr。
类似用法:
1
2
3
4
5
isa <CallInst>(&I);dyn_cast <BranchInst>(&I);dyn_cast <LoadInst>(&I);dyn_cast <StoreInst>(&I);dyn_cast <PHINode>(&I);
判断操作码
1
2
if (BO->getOpcode () != Instruction::Add) continue ;
这里只处理 add。其他常见操作码包括:
1
2
3
4
5
6
7
8
Instruction::Sub Instruction::Mul Instruction::Xor Instruction::And Instruction::Or Instruction::Shl Instruction::LShr Instruction::AShr
获取操作数
对于:
得到 %x;
得到 0。
使用 PatternMatch 匹配零
1 match (BO->getOperand (1 ), m_Zero ())
匹配:
而:
1 match (BO->getOperand (0 ), m_Zero ())
匹配:
替换所有使用
1 BO->replaceAllUsesWith (Replacement);
原来:
1
2
%a = add i32 %x , 0 (这个表示BO)%b = mul i32 %a , 2
替换后:
1
2
%a = add i32 %x , 0 %b = mul i32 %x , 2
这一步只修改使用关系,原 add 指令暂时还存在。
删除指令
将指令从所属 BasicBlock 删除。
这里我们需要暂存BO是因为在遍历 IR 的同时修改 IR,
迭代器会失效,导致漏处理、重复处理,甚至崩溃
所以我们就先把要改的对象存储下来
如何加载 Pass
LLVM 加载 Pass 有 4 种方式:
1. New PM 动态插件
把 Pass 编译成 .so,再让 opt 或 clang 动态加载。当前 mypass 使用的就是这种方式。
注册:New PM Pass 需要实现 PassInfoMixin,并通过 llvmGetPassPluginInfo() 导出插件入口:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
class RemoveAddZeroPass : public PassInfoMixin<RemoveAddZeroPass> {public : PreservedAnalyses run (Function &F, FunctionAnalysisManager &AM) { } }; extern "C" LLVM_ATTRIBUTE_WEAK PassPluginLibraryInfo llvmGetPassPluginInfo () { return { LLVM_PLUGIN_API_VERSION, "RemoveAddZeroPass" , LLVM_VERSION_STRING, [](PassBuilder &PB) { PB.registerPipelineParsingCallback ( [](StringRef Name, FunctionPassManager &FPM, ArrayRef<PassBuilder::PipelineElement>) { if (Name == "remove-add-zero" ) { FPM.addPass (RemoveAddZeroPass ()); return true ; } return false ; }); }}; }
编译:
1
2
cmake -S mypass -B mypass/build -DLLVM_DIR=<你的LLVM_DIR> cmake --build mypass/build
调用:
1
2
opt -load-pass-plugin=./mypass/build/MyFirstPass.so -passes=remove-add-zero -S test.ll -o test.opt.ll clang -fpass-plugin=./mypass/build/MyFirstPass.so -O1 test.c -o test
注意:-fpass-plugin 要生效,插件通常还需要注册 pipeline 扩展点,不能只注册 registerPipelineParsingCallback()。
2. Legacy PM 动态插件
老式 FunctionPass 编译成 .so,再用 -load 加载。
注册:Legacy Pass 需要继承 FunctionPass,实现 runOnFunction(),并用 INITIALIZE_PASS 注册命令行名字:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
struct MyLegacyPass : public FunctionPass { static char ID; MyLegacyPass () : FunctionPass (ID) {} bool runOnFunction (Function &F) override return false ; } }; char MyLegacyPass::ID = 0 ;INITIALIZE_PASS (MyLegacyPass, "my-legacy-pass" , "My Legacy Pass" , false , false )
编译:
1
2
3
4
5
add_llvm_library(MyLegacyPass MODULE MyLegacyPass.cpp PLUGIN_TOOL opt )
调用:
1 opt -load ./MyLegacyPass.so -my-legacy-pass ...
1 clang -Xclang -load -Xclang ./MyLegacyPass.so ...
LLVM 17 的 opt 同时支持:
1
2
-load 旧 Pass Manager 插件 -load-pass-plugin 新 Pass Manager 插件
3. 静态内置 Pass
把 Pass 源码编进 LLVM,并在 PassBuilder.cpp 里注册。
注册:需要把源码加入 LLVM 的 CMake,并在 PassBuilder.cpp 中注册命令行开关和 pipeline:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 #include "Obfuscation/Flattening.h" static cl::opt<bool > s_obf_fla ("fla" , cl::init(false ), cl::desc("Flattening" )) PassBuilder::PassBuilder (...) { this ->registerPipelineStartEPCallback ( [](ModulePassManager &MPM, OptimizationLevel Level) { FunctionPassManager FPM; FPM.addPass (FlatteningPass (s_obf_fla)); MPM.addPass (createModuleToFunctionPassAdaptor (std::move (FPM))); }); }
编译:需要重新构建 LLVM 工具链:
1 cmake --build llvm-build-17.0.6-obf --target opt clang
调用:
1
2
clang -mllvm -fla -c test.c -o test.o opt -passes=flattening ...
OLLVM 的 fla、bcf、sub 都属于这种方式,不需要加载 .so。
4. PassBuilder 回调自动注册
Pass 可以不通过命令行名字调用,而是注册到 pipeline 扩展点,让 clang/opt 在指定阶段自动运行。
注册:动态插件或静态内置都可以使用回调注册。动态插件写法如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
extern "C" LLVM_ATTRIBUTE_WEAK PassPluginLibraryInfo llvmGetPassPluginInfo () { return { LLVM_PLUGIN_API_VERSION, "RemoveAddZeroPass" , LLVM_VERSION_STRING, [](PassBuilder &PB) { PB.registerPipelineStartEPCallback ( [](ModulePassManager &MPM, OptimizationLevel Level) { FunctionPassManager FPM; FPM.addPass (RemoveAddZeroPass ()); MPM.addPass (createModuleToFunctionPassAdaptor (std::move (FPM))); }); }}; }
编译:动态插件用 add_llvm_pass_plugin,静态内置用 cmake --build ... --target opt clang。
调用:不需要 -passes=name,让 clang 或 opt 自动执行:
1 clang -fpass-plugin=./mypass/build/MyFirstPass.so -O1 test.c -o test
或者在静态内置情况下直接正常编译:
1 clang -O1 test.c -o test
常用扩展点:
registerPipelineStartEPCallback():pipeline 开始。registerPipelineEarlySimplificationEPCallback():早期简化。registerOptimizerEarlyEPCallback():优化早期。registerOptimizerLastEPCallback():优化最后。
IR
表示Intermediate Representation ,中间代码
使用作为后端的llvm 编译器编译的各种语言,都可以 转化成IR代码,之后再转化成机器码
IR的结构如下
1
2
3
4
5
6
7
8
9
10
11
12
Module ├── 全局变量 GlobalVariable ├── 函数 Function │ ├── 参数 Argument │ └── 基本块 BasicBlock(包含入口块) │ ├── PHI 指令(根据“在当前 block 之前执行的是哪一个 predecessor(前任) block”来得到相应的值) │ ├── 普通指令 │ └── 终结指令 Terminator ├── 全局别名 GlobalAlias ├── 间接函数 GlobalIFunc ├── Metadata └── Module Flags、Comdat 等辅助信息
上面表示了IR的基本结构
静态单赋值(SSA)
what is:编译的中间层IR,每个变量只能赋值一次.很容易理解对吧
之后我们可以引申一下phi指令了
1
2
3
4
5
6
7
8
9
10
NOINLINE int test_if_else (int x) { int y; if (x > 0 ) y = 10 ; else y = 20 ; return y; }
比如这个,不开优化编译llvm,选择o2
clang++ -S -emit-llvm -O0 -Xclang -disable-O0-optnone test_control_flow.cpp
-o /tmp/noopt.ll
opt -passes=mem2reg -S /tmp/noopt.ll -o /tmp/phi.ll
那么就可以看到Phi
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
define dso_local noundef i32 @_Z12test_if_elsei(i32 noundef %x) #0 { entry: %cmp = icmp sgt i32 %x, 0 br i1 %cmp, label %if .then, label %if .else if .then: ; preds = %entry br label %if .end if .else : ; preds = %entry br label %if .end if .end: ; preds = %if .else , %if .then %y.0 = phi i32 [ 10 , %if .then ], [ 20 , %if .else ] ret i32 %y.0 }
可以发现这里用phi函数,来选择把前面哪个块的值作为%y.0,根据前面调用的是哪个块来判断
LLVM IR指令
终结指令 Terminator Instructions
基本块的最后一个指令,通常为跳转指令或返回指令。
add sub 这种
按位二元运算 Bitwise Binary Operations
shl 左移右移,xor这种
内存访问和寻址操作 Memory Access and Addressing Operations
alloca:类似于malloc
类型转换操作 Conversion Operations
其他操作 Other Operations
phi select 和call
各种混淆
后续示例demo代码
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 #include "tea.h" #include <iostream> #include <string> #include <cstring> #include <cstdint> int main () uint32_t key[4 ] = { 0x10345678 , 0x9abcdef0 , 0x11223344 , 0x55667788 }; TEA tea (key) ; static const unsigned char cipher[24 ] = { 0x22 , 0xec , 0x42 , 0x47 , 0xfe , 0xf0 , 0xbf , 0x40 , 0x45 , 0x49 , 0xf7 , 0x4b , 0x5e , 0x65 , 0x66 , 0x27 , 0x23 , 0x2e , 0xbf , 0x09 , 0x89 , 0xf0 , 0x60 , 0xba }; constexpr std::size_t FLAG_LEN = 22 ; std::string input; std::cout << "Enter the flag: " ; std::getline (std::cin, input); if (input.size () != FLAG_LEN) { std::cout << "Wrong flag!" << std::endl; return 1 ; } unsigned char buf[24 ] = {0 }; std::memcpy (buf, input.c_str (), FLAG_LEN); for (int i = 0 ; i < 3 ; i++) { uint32_t v0, v1; std::memcpy (&v0, buf + i * 8 , 4 ); std::memcpy (&v1, buf + i * 8 + 4 , 4 ); tea.encrypt (v0, v1); std::memcpy (buf + i * 8 , &v0, 4 ); std::memcpy (buf + i * 8 + 4 , &v1, 4 ); } if (std::memcmp (buf, cipher, sizeof (cipher)) == 0 ) { std::cout << "Correct! flag is accepted." << std::endl; return 0 ; } std::cout << "Wrong flag!" << std::endl; return 1 ; }
虚假控制流(BogusControlFlow)
虚假控制流指,通过向正常控制流中插入若干不可达基本块 (永远不会被执行的基本块)和由不透明谓词 (指一个表达式,它的值在执行到某处时,对程序员而言必然是已知的,但是由于某种原因,编译器或者说静态分析器无法推断出这个值,只能在运行时确定)造成的虚假跳转,以产生大量垃圾代码干扰攻击者分析的混淆。
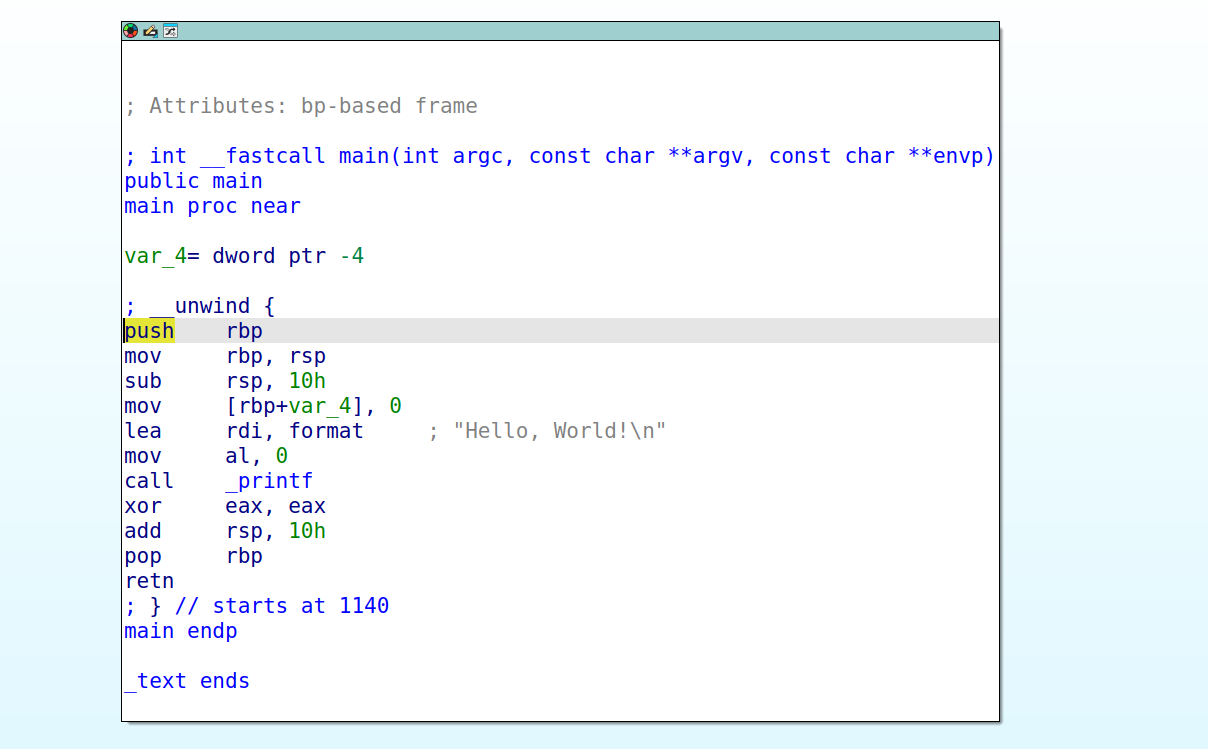
比如这里一个简单的hello world
之后我们在
这是原本的结构
混淆之后
D810
D810 (又称 Deobfuscator-810)是一个用于 IDA Pro 的强大代码去混淆(Deobfuscation)插件 。它主要通过在反编译时修改 IDA 的微代码(Microcode),将复杂、难以阅读的混淆代码还原为清晰、直观的逻辑
微代码,就类似于IR.
如何使用?
建立规则文件.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
from d810.mba.dsl import Var, Const, DynamicConstfrom d810.mba.rules._base import VerifiableRulex = Var("x_0" ) ONE = Const("1" , 1 ) ZERO_VAL = DynamicConst("val_0" , lambda ctx: 0 ) _ALL_MATURITIES = [2 , 3 , 4 , 5 ] class MyPredOddConsecutive (VerifiableRule ): maturities = _ALL_MATURITIES PATTERN = ((x - ONE) * x) & ONE REPLACEMENT = ZERO_VAL DESCRIPTION = "((x-1)*x)&1 -> 0" REFERENCE = "main_bcf OLLVM BCF"
这里是让ai写的然后我们加载我们的json文件
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
{ "description" : "[Step 1: BCF] OLLVM 虚假控制流去混淆:折叠恒真谓词 + 清除假循环 + 拉直恒真跳转" , "_notes" : { "整体说明" : "BCF(虚假控制流)去混淆。OLLVM -bcf 会生成:①恒真/恒假谓词 ②空转假循环 ③等价复制块。本配置三件套齐活:ins_rules 折叠谓词算术、BadWhileLoop 清假循环、JumpFixer 拉直恒真跳转。" , "注释位置说明" : "每条规则的注释放在 config._comment 里(唯一合法的内联位置)。规则条目 name 同级加字段会崩(cls(**data)),顶层 _notes 是整体注释。" , "blk_rules_说明" : "4 条块级规则处理控制流结构。其中 Unflattener 是给 FLA(平坦化)预留的,纯 BCF 时基本不触发(无害兜底)。" } , "ins_rules" : [ { "name" : "MyPredOddConsecutive" , "is_activated" : true , "config" : { "_comment" : "匹配 ((x-1)*x)&1(clang 编译顺序,(x-1) 在前)→ 折叠成 0" } } , { "name" : "MyPredOddConsecutive2" , "is_activated" : true , "config" : { "_comment" : "匹配 (x*(x+1))&1(另一种连续整数变体)→ 折叠成 0" } } , { "name" : "MyPredOddNotZero" , "is_activated" : true , "config" : { "_comment" : "匹配 (((x-1)*x)&1) != 0(setnz 比较结果形态)→ 折叠成 0" } } , { "name" : "MyPredOddConsecutive3" , "is_activated" : true , "config" : { "_comment" : "匹配 (x*(x-1))&1(gcc 编译顺序,x 在前)→ 折叠成 0" } } , { "name" : "MyXduPredOdd" , "is_activated" : true , "config" : { "_comment" : "匹配 Zext(((x-1)*x)&1, 32)==0(-O3 的 xdu 包裹形态)→ 折叠成 1(恒真)" } } ] , "blk_rules" : [ { "name" : "MbaStatePreconditioner" , "is_activated" : true , "config" : { "_comment" : "反混淆前热身:对谓词/分发器算术做 1 轮局部化简(保守),让后续规则好识别" , "max_optimize_local_rounds" : 1 } } , { "name" : "BadWhileLoop" , "is_activated" : true , "config" : { "_comment" : "清除 BCF 产生的空转假循环 while(...); 结构" } } , { "name" : "Unflattener" , "is_activated" : true , "config" : { "_comment" : "OLLVM FLA 反平坦化:检测并拆除 dispatcher 分发器(纯 BCF 时基本不触发,预留)" , "max_passes" : 5 , "min_dispatcher_internal_block" : 2 , "min_dispatcher_exit_block" : 2 , "min_dispatcher_comparison_value" : 2 , "max_calls_entry_preds" : 24 , "max_calls_exit_blocks" : 24 , "defer_calls_on_conditional_entry_father" : true , "log_calls_layout_signals" : true , "min_entropy" : 0.0 , "max_entropy" : 1.0 } } , { "name" : "JumpFixer" , "is_activated" : true , "config" : { "_comment" : "拉直恒真/恒假条件跳转;enabled_rules 白名单控制启用哪些子规则" , "enabled_rules" : [ "CompareConstantRule1" , "CompareConstantRule2" , "CompareConstantRule3" , "JaeRule1" , "JbRule1" , "JnzRule1" , "JnzRule2" , "JnzRule3" , "JnzRule4" , "JnzRule5" , "JnzRule6" , "JnzRule7" , "JnzRule8" , "JmpRuleZ3Const" , "MyOllvmXduJz" ] , "dump_intermediate_microcode" : false } } ] }
放在这里就行了./home/f0x/.idapro/plugins/d810-ng/src/d810/conf/
之后我们加载这个文件,还有就是按需去混淆,不然如果什么去混淆都同时加上去效果可能没那么理想
按下f5,选择对应的json文件
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
void __fastcall TEA::encrypt (TEA *this , uint32_t **p_v0, uint32_t **p_v1) uint32_t **v3; int *v4; int *v5; uint32_t **v6; _DWORD *v7; uint32_t *v8; int *v9; int *v10; int *v11; int v12; int v13; int v14; int v15; int v16; uint32_t v17; uint32_t **v18; uint32_t *v19; uint32_t ***v20; uint32_t **v21; int *v22; uint32_t v23; int *v24; uint32_t v25; uint32_t **v26; uint32_t **p_v0a; uint32_t **p_v1a; uint32_t *p_sum; uint32_t ***i; int *p_t ; int *p_shl; int *p_shr; int *p_shl2; int *p_shr2; uint32_t **v37; TEA *v38; uint32_t **v39; uint32_t **v40; v38 = this ; v39 = p_v0; v40 = p_v1; p_v0a = (uint32_t **)(&v26 - 2 ); p_v1a = (uint32_t **)(&v26 - 2 ); p_sum = (uint32_t *)(&v26 - 2 ); i = &v26 - 2 ; p_t = (int *)(&v26 - 2 ); p_shl = (int *)(&v26 - 2 ); p_shr = (int *)(&v26 - 2 ); p_shl2 = (int *)(&v26 - 2 ); p_shr2 = (int *)(&v26 - 2 ); v26 = p_v1; v37 = p_v1; *(_DWORD *)p_v1 = *((_DWORD *)p_v1 + 3 ); *(_DWORD *)v26 ^= *((_DWORD *)p_v1 + 2 ) ^ *((_DWORD *)p_v1 + 1 ); LODWORD (v26) = 0 ; while ( *(_DWORD *)i < 64 ) { v3 = p_v1a; v4 = p_shr2; v5 = p_shl2; v6 = v37; v7 = i; v8 = p_sum; v9 = p_shr; v10 = p_shl; v11 = p_t ; *p_sum -= 2048144777 ; *v11 = *v7 & 1 ; v12 = 3 ; if ( *v11 ) v12 = 5 ; *v10 = v12; v13 = 5 ; if ( *v11 ) v13 = 3 ; *v9 = v13; v14 = 5 ; if ( *v11 ) v14 = 3 ; *v5 = v14; v15 = *v11; v16 = 3 ; if ( v15 ) v16 = 5 ; *v4 = v16; v17 = `anonymous namespace '::mix( **v3, *v8, *((_DWORD *)v6 + (*v7 & 3)), *((_DWORD *)v6 + (((unsigned __int8)*v7 + 1) & 3)), *v10, (int *)(unsigned int)*v9); v18 = p_v0a; v19 = p_sum; v20 = i; v21 = v37; v22 = p_shl2; v23 = v17; v24 = p_shr2; **p_v0a += v23; v25 = `anonymous namespace' ::mix ( **v18, *v19, *((_DWORD *)v21 + (((unsigned __int8)*(_DWORD *)v20 + 2 ) & 3 )), *((_DWORD *)v21 + (((unsigned __int8)*(_DWORD *)v20 + 3 ) & 3 )), *v22, (int *)(unsigned int )*v24); **p_v1a += v25; ++*(_DWORD *)i; } }
很明显还是有点丑陋,不过勉强能看了.块结构已经明晰了.
修改 不透明谓词的全局变量
把上面的x添加值就行,不过我改了没用,hyw,没找到具体原因放在这里吧
模拟执行
虽然感觉用在这里有点大炮打蚊子了,写起来还是比较麻烦的,这里就当作学习如何使用了,比较适合特别复杂的情况
什么是模拟执行:,来解释和运行代码的技术,而不需要在真实的物理硬件上直接执行.这里我们以qiling为示例.
qiling的组成
组件
作用
Unicorn 引擎
模拟 CPU(指令、寄存器、内存)
Qiling 加载器
解析 ELF、PIE 重定位、模拟动态链接
Qiling 系统调用层
模拟 read/write/futex 等系统调用
rootfs
模拟器里的"文件系统根"(动态库从这读
hook
级别
API
触发时机
本教程用途
指令级
hook_code(cb, begin, end)每条指令执行前
阶段 1:恢复加密代码
基本块级
hook_block(cb, begin, end)每个基本块入口
阶段 3:动态轨迹
地址级
hook_address(cb, addr)RIP 命中指定地址
阶段 2:取数 / -f 强制相等
指令类型级
hook_insn(cb, 类型)特定指令(如 syscall/cpuid)
—
中断级
hook_intr / hook_intno中断触发
—
内存级
hook_mem_read/write/fetch 及 _invalid/_unmapped 变体内存访问 / 访问非法内存
可做反调试、内存追踪
函数级 ql.os.set_api("函数名", cb, intercept)按名字拦截库函数 (经 PLT/GOT)可替代 -f:set_api("memcmp", cb, EXIT) 改返回值
系统调用级
ql.os.set_syscall("read", cb)系统调用
观察 stdin 读取时机
管理
hook_del(hret)删除已注册的 hook
—
回调里可读寄存器(ql.arch.regs.rdi)、读内存(ql.mem.read)、改寄存器 。
示例
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 """ step0_minimal.py — Qiling 零基础最小示例(逐行注释)。 作用:把 tea/build/main_bcf 完整模拟跑起来, 在"主程序自己的代码"上挂一个指令级 hook,打印前 20 条指令, 然后让它跑完,看看 stdout 是什么。 用法: /home/f0x/anaconda3/envs/frida/bin/python step0_minimal.py 和 trace.py 的区别:这只是教学示例,trace.py 才是真正干活的。 """ import iofrom qiling import Qilingql = Qiling(["../build/main_bcf" ], "./ubuntu24_rootfs" , multithread=True , verbose=0 ) ql.os.stdin = io.BytesIO(b"flag{aaaaaaaaaaaaaa}" ) out = io.BytesIO() ql.os.stdout = out main_img = None for img in ql.loader.images: if "main_bcf" in img.path: main_img = img break lo, hi = main_img.base, main_img.end print (f"主镜像: {main_img.path} " )print (f" 加载地址 base = {hex (lo)} 结束 end = {hex (hi)} " )count = 0 MAX = 20 def on_insn (ql, address, size ): global count if lo <= address < hi and count < MAX: print (f" 执行到指令 @ {hex (address)} " ) count += 1 ql.hook_code(on_insn) print ("\n开始模拟执行..." )ql.run() print (f"\n退出码: {ql.os.exit_code} " )print (f"程序输出: {out.getvalue()!r} " )print (f"\n小结: 程序被完整模拟跑了 {count} + 条主程序指令," )print (" read(0) 读到了我们喂的输入, write(1) 输出了结果。" )print (" → 这就是'模拟执行':CPU、系统调用、动态链接全部被 Qiling 模拟了。" )
这里就是遍历执行过的每条指令.如果要去bcf我们该怎么做呢.显然我们可以执行并判断我们走过了哪些块.我们需要判断两部分可能
1.验证flag 正确 2. 验证flag错误,有着两条路.
我们这里需要匹配判断指令的位置并hook那个,并修改判断逻辑.
我们就能走完两条路线的所有block
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 """ trace.py — 用 Qiling 跑 main_bcf, 记录"真正执行过的基本块"。 去混淆原理: OLLVM BCF 会在基本块之间插入不透明谓词 + 垃圾块 (bogus block)。 不透明谓词在运行时恒真/恒假, 所以垃圾块永远不会被执行 (或者只走其中一个分支)。 因此: 动态执行轨迹里出现过的基本块 = 真实控制流; 静态 CFG 里有、但从未执行的块 = BCF 垃圾块候选。 重要: 本脚本【不需要知道 flag】! 垃圾块与输入内容无关——无论喂什么输入, 垃圾块都不会执行。 默认喂 22 个 'A' (任意输入) 就能拿到真实路径的轨迹。 多喂几组不同输入只是为了覆盖更多分支 (如 Wrong flag 分支), 让后续 analyze 找垃圾块找得更全, 与 flag 是否正确无关。 用法: /home/f0x/anaconda3/envs/frida/bin/python trace.py [选项] [输入文件] [输出前缀, 默认 executed] 不带参数 = 喂 22 个 'A' (任意输入), 输出 executed.txt 带输入文件 = 喂该文件内容, 输出 <前缀>.txt -f/--force-correct = hook memcmp 强制相等, 覆盖 "Correct" 分支轨迹 (不需要知道 flag; 不知道 flag 也能覆盖所有分支) 多次运行后合并: cat executed_a.txt executed_b.txt | sort -u > executed.txt 输出: <前缀>_blocks.json {运行时地址: 执行次数} <前缀>_edges.json [[from, to], ...] 执行过的控制流边 <前缀>.txt 主程序镜像内执行过的块地址 (运行时地址, 已排序) """ import ioimport jsonimport sysfrom qiling import QilingDEFAULT_PAYLOAD = b"A" * 22 MEMCMP_CALL_OFF = 0x2c08 def main (): import argparse ap = argparse.ArgumentParser(description="Qiling 基本块级轨迹 (不需要知道 flag)" ) ap.add_argument("input" , nargs="?" , default=None , help ="输入文件; 缺省 = 22 个 'A' (任意输入)" ) ap.add_argument("prefix" , nargs="?" , default="executed" , help ="输出前缀, 默认 executed" ) ap.add_argument("-f" , "--force-correct" , action="store_true" , help ="hook memcmp 强制相等 → 程序走 'Correct' 分支, " "覆盖正确路径的轨迹 (不需要知道 flag)" ) a = ap.parse_args() payload = open (a.input , "rb" ).read() if a.input else DEFAULT_PAYLOAD prefix = a.prefix out = io.BytesIO() ql = Qiling(["../build/main_bcf" ], "./ubuntu24_rootfs" , multithread=True , verbose=0 ) ql.os.stdin = io.BytesIO(payload) ql.os.stdout = out main_img = None for img in ql.loader.images: if "main_bcf" in img.path: main_img = img break lo, hi = main_img.base, main_img.end print (f"main image: {main_img.path} {hex (lo)} - {hex (hi)} " ) if a.force_correct: def force_memcmp_eq (ql ): ql.arch.regs.rdi = ql.arch.regs.rsi ql.hook_address(force_memcmp_eq, lo + MEMCMP_CALL_OFF) print ("[force-correct] memcmp 已被强制相等, 将覆盖 Correct 分支" ) blocks = {} edges = [] last = None def on_block (ql, address, size ): nonlocal last if lo <= address < hi: blocks[address] = blocks.get(address, 0 ) + 1 if last is not None and last != address: edges.append((last, address)) last = address ql.hook_block(on_block) ql.run() print ("exit code:" , ql.os.exit_code) print ("stdout:" , out.getvalue()) with open (f"{prefix} _blocks.json" , "w" ) as f: json.dump({hex (k): v for k, v in sorted (blocks.items())}, f, indent=1 ) with open (f"{prefix} _edges.json" , "w" ) as f: json.dump([[hex (a), hex (b)] for a, b in edges], f, indent=1 ) with open (f"{prefix} .txt" , "w" ) as f: for a in sorted (blocks): f.write(f"{a:016x} \n" ) print (f"\nexecuted {len (blocks)} unique blocks in main image" ) print (f"results saved: {prefix} _blocks.json, {prefix} _edges.json, {prefix} .txt" ) if __name__ == "__main__" : main()
这里我们把判断wrong和correct的两个文件合并一下合并一下
1
2
3
4
5
6
$PY trace.py $PY trace.py -f $PY trace.py wrong_input.txt wrong cat executed.txt wrong.txt | sort -u > executed_all.txt cp executed_all.txt executed.txt $PY analyze.py
执行的analyze.py如下,遍历出所有的所有存在的块,减去执行经过的块,最后得到 无效的块并nop掉
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 """ analyze.py — 静态 CFG vs 动态轨迹, 找出 BCF 垃圾块 (按函数分析)。 用法: /home/f0x/anaconda3/envs/frida/bin/python analyze.py [rva_of_function] 原理: 1. 从 ELF 符号表拿函数边界 (main_bcf 未 strip, 有符号); 2. 对每个"被动态执行过"的函数, 用递归下降反汇编重建静态基本块; 3. 静态块 - 动态执行块 = 该函数内的 BCF 垃圾块候选。 注意: - 整个函数都没被执行过 (如 TEA::decrypt, main 没调用它) 会被单列为 "dead function", 它们不是 BCF 垃圾, 只是这次输入没走到。 - 想覆盖更多分支 (如 Wrong flag 分支), 用不同输入多跑几次 trace.py, 然后把多个 executed.txt 合并后再分析 (见 merge 说明)。 输出: junk_rva.txt / junk_blocks.txt 垃圾块地址 (RVA / 运行时地址) real_blocks.txt 真实执行过的块 """ import jsonimport sysfrom capstone import Cs, CS_ARCH_X86, CS_MODE_64from elftools.elf.elffile import ELFFileBINARY = "../build/main_bcf" RUNTIME_BASE = 0x555555554000 def get_functions (): """从符号表提取 {名称: (起始RVA, )}。""" funcs = {} with open (BINARY, "rb" ) as f: elf = ELFFile(f) for sym in elf.get_section_by_name(".symtab" ).iter_symbols(): if sym.entry.st_info.type == "STT_FUNC" and sym.entry.st_size > 0 : name = sym.name or f"sub_{sym.entry.st_value:x} " funcs[name] = (sym.entry.st_value, sym.entry.st_value + sym.entry.st_size) return funcs def load_text (): with open (BINARY, "rb" ) as f: elf = ELFFile(f) sec = elf.get_section_by_name(".text" ) return sec.data(), sec["sh_addr" ] def static_blocks_in (func_start, func_end, code, text_vaddr ): """ 递归下降反汇编 [func_start, func_end), 返回静态基本块入口集合。 从函数入口开始, 沿 jcc 两条边 / jmp / 顺序流向下走, 遇到 ret 停。 """ md = Cs(CS_ARCH_X86, CS_MODE_64) md.detail = True def rva_to_off (rva ): return rva - text_vaddr visited_insn = set () blocks = set () worklist = [func_start] while worklist: pc = worklist.pop() off = rva_to_off(pc) if not (0 <= off < len (code)) or pc >= func_end: continue block_start = pc while True : if pc in visited_insn or pc >= func_end: break visited_insn.add(pc) o = rva_to_off(pc) insn = next (md.disasm(code[o:o + 15 ], pc), None ) if insn is None : break pc += insn.size if insn.mnemonic in ("ret" , "retq" , "jmp" , "jb" , "jae" , "je" , "jne" , "jg" , "jge" , "jl" , "jle" , "ja" , "jbe" , "js" , "jns" , "jo" , "jno" , "jz" , "jnz" , "jecxz" , "loop" ): if len (insn.operands) > 0 and insn.operands[0 ].type == 2 : worklist.append(insn.operands[0 ].imm) if insn.mnemonic != "jmp" : worklist.append(pc) break blocks.add(block_start) return blocks def block_extents_in (func_start, func_end, code, text_vaddr, blocks ): """ 给一组块入口补上结束地址: 每个块的 [start, next_start) 或到函数末尾。 返回 {start: end}。用于 patch.py 把垃圾块 NOP 掉。 """ starts = sorted (b for b in blocks if func_start <= b < func_end) ext = {} for i, s in enumerate (starts): e = starts[i + 1 ] if i + 1 < len (starts) else func_end ext[s] = e return ext def main (): funcs = get_functions() executed = set () try : with open ("executed.txt" ) as f: executed = {int (l.strip(), 16 ) for l in f if l.strip()} except FileNotFoundError: print ("先运行 trace.py 生成 executed.txt" ) return code, text_vaddr = load_text() print (f"{'function' :<36 } {'static' :>7 } {'exec' :>6 } {'junk' :>6 } " ) all_junk = set () junk_extents = {} dead_funcs = [] for name, (s, e) in sorted (funcs.items(), key=lambda kv: kv[1 ][0 ]): func_exec = [a for a in executed if s + RUNTIME_BASE <= a < e + RUNTIME_BASE] if not func_exec: dead_funcs.append((name, s, e)) continue sblocks = static_blocks_in(s, e, code, text_vaddr) sblocks_r = {a + RUNTIME_BASE for a in sblocks} junk = sblocks_r - executed all_junk |= junk extents = block_extents_in(s, e, code, text_vaddr, sblocks) for j in junk: junk_extents[j - RUNTIME_BASE] = extents[j - RUNTIME_BASE] print (f"{name:<36 } {len (sblocks_r):>7 } {len (func_exec):>6 } {len (junk):>6 } " ) print (f"\ndead functions (never entered this run):" ) for name, s, e in dead_funcs: print (f" {name} [{s:08x} , {e:08x} )" ) with open ("junk_rva.txt" , "w" ) as f: for a in sorted (all_junk): f.write(f"{a - RUNTIME_BASE:08x} \n" ) with open ("junk_blocks.txt" , "w" ) as f: for a in sorted (all_junk): f.write(f"{a:016x} \n" ) with open ("junk_extents.json" , "w" ) as f: json.dump({f"{s:08x} " : f"{e:08x} " for s, e in sorted (junk_extents.items())}, f, indent=1 ) print (f"\ntotal junk blocks: {len (all_junk)} -> junk_rva.txt / junk_blocks.txt / junk_extents.json" ) if __name__ == "__main__" : main()
之后我们执行patch.py nop掉所有无用的块就行
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 """ patch.py — 把 BCF 垃圾块 NOP 掉, 生成去混淆副本。 用法: /home/f0x/anaconda3/envs/frida/bin/python patch.py 前置: 先跑 trace.py (喂多个输入合并) + analyze.py 生成 junk_extents.json 安全依据: 垃圾块 = 静态可达、动态从未执行。真实代码的不透明谓词分支永远 不往垃圾块跳, 所以把它们整块替换成 0x90 (NOP) 不影响运行。 补丁后会用 Qiling 重新跑一遍验证行为一致。 输出: ../build/main_bcf_patched 去混淆后的二进制副本 (NOP 填满垃圾块) """ import jsonimport osimport shutilBINARY = "../build/main_bcf" PATCHED = "../build/main_bcf_patched" TEXT_VADDR = 0x10D0 NOP = b"\x90" def main (): with open ("junk_extents.json" ) as f: extents = {int (k, 16 ): int (v, 16 ) for k, v in json.load(f).items()} shutil.copy(BINARY, PATCHED) total = 0 with open (PATCHED, "r+b" ) as f: for start, end in sorted (extents.items()): off, size = start, end - start if size <= 0 : continue f.seek(off) f.write(NOP * size) total += size print (f"patched {len (extents)} junk blocks, {total} bytes NOPed -> {PATCHED} " ) if __name__ == "__main__" : main()
SUB :Instruction Substitution,指令替换混淆示例
替换后(恒等):
1
2
%neg = sub i32 0, %b ; -b %r = sub i32 %a, %neg ; a - (-b) == a + b
替换成更难看的恒等式子,不过肯定不会只有这么简单一般
这个ollvm 17替换规则如下
原运算
等价替换(本 fork 实现的变体)
a + ba - (-b);-((-a) + (-b));((a + r) + b) - r;((a - r) + b) + r(r 为随机常量)
a - ba + (-b);(a + r) - (b + r);(a - r) - (b - r)
a & b(a ^ ~b) & a;随机常量变体
a| b
(a & b) | (a ^ b);随机常量变体
a ^ b(~a & b) | (a & ~b);随机常量变体
如果只有一层,一般ida 自己就优化了.这里我们示例开的是三层sub_loop
不过完全可以用一个例如GAMBA 等工具去解决.这里就不详细说了
sobf-- String Obfuscation(字符串混淆)
字符串加密解密函数有时候放在.init_array 里面,有时候放在放在.text通过call调用
这里是第二种形式
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
__int64 __fastcall sub_14C0 (__int64 a1, __int64 a2) { __int64 result; int v3; result = 0LL ; v3 = 0 ; if ( dword_4080 != 1 ) { do { *(_BYTE *)(a1 + v3) = *(_BYTE *)(a2 + v3 % 22u ) ^ *(_BYTE *)(a2 + 22 + v3); result = (unsigned int )++v3; } while ( v3 != 17 ); dword_4080 = 1 ; } return result; }
其实就是xor.调试什么的都行,或者模拟执行把解密后的都保存下来.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 """ sobf_decrypt_dump.py — 针对 sobf(字符串加密) 的模拟执行解密 dump。 原理: sobf 把 C 字符串加密存 .rodata, 运行时由 goron_decrypt_string_* 解密, 把明文写入 .bss/.data 里的"解密后变量"。所以: 静态看 .rodata = 密文 (strings 看不到明文) 动态跑完后 .bss/.data = 明文 用 Qiling 模拟执行, 跑完后扫描主镜像内存的 ASCII 串, 就能拿到所有被 sobf 解密出来的原始字符串。 (这个方案 "只 dump 不改 ELF", 比 hook 解密函数更简单可靠——不需要定位 或解析解密函数, 明文解密后自然出现在可写段里。) 用法: /home/f0x/anaconda3/envs/frida/bin/python sobf_decrypt_dump.py <目标二进制> [输入文件] """ import importlib.utilimport ioimport reimport sysfrom elftools.elf.elffile import ELFFilefrom qiling import Qilingdef find_main_image (ql, name_hint ): """在 ql.loader.images 里找主程序镜像。""" for img in ql.loader.images: if name_hint in img.path: return img return ql.loader.images[0 ] def extract_ascii (data: bytes , min_len=4 ): """从内存字节里提取所有可打印 ASCII 字符串。""" return [m.decode() for m in re.findall(rb'[\x20-\x7e]{%d,}' % min_len, data)] def main (): if len (sys.argv) < 2 : print ("用法: python sobf_decrypt_dump.py <目标二进制> [输入文件]" ) return binary = sys.argv[1 ] payload = open (sys.argv[2 ], "rb" ).read() if len (sys.argv) > 2 else b"A" * 22 ql = Qiling([binary], "/" , multithread=True , verbose=0 ) ql.os.stdin = io.BytesIO(payload) ql.os.stdout = io.BytesIO() out_buf = bytearray () def on_write (ql ): nonlocal out_buf fd, buf, count = ql.arch.regs.rdi, ql.arch.regs.rsi, ql.arch.regs.rdx if fd == 1 : out_buf += bytes (ql.mem.read(buf, count)) ql.os.set_syscall("write" , on_write) ql.run() base = ql.loader.load_address elf = ELFFile(open (binary, "rb" )) plaintext = [] for sec in elf.iter_sections(): if sec.name not in (".data" , ".bss" ) or not sec["sh_addr" ]: continue try : seg_data = bytes (ql.mem.read(sec["sh_addr" ] + base, sec["sh_size" ])) except Exception: continue plaintext.extend(extract_ascii(seg_data, min_len=4 )) plaintext.extend(extract_ascii(bytes (out_buf), min_len=4 )) noise = ("GCC" , "GNU" , "GLIBC" , "GLIBCXX" , "crtstuff" , "_Z" , "@GLIBC" , "std::" , "libc" , "libstd" , "libm" , "libgcc" , "/lib64" , "ld-linux" ) seen, uniq = set (), [] for s in plaintext: if not any (t in s for t in noise) and s not in seen: seen.add(s) uniq.append(s) print (f"主镜像: {binary} \n运行时: {hex (base)} \n" ) print ("=== sobf 解密后, 拿到的明文字符串 ===" ) for s in uniq: print (f" {s!r} " ) if __name__ == "__main__" : main()
这里还是ai写的,我们hook所有的系统调用write 来输出
split —— Basic Block Splitting(基本块分割)
把一个大的基本块分割成为N个小基本块,不过一般会被ida优化,建议搭配 fla或者 bcf食用
ibr —— Indirect Branch(间接分支)
关于简介调用,打开了我们可能就只能看到这个样子因为有分支就会被 打断.具体是怎样的
1
2
3
4
if (x > 10 ) foo (); else bar ();
这种,就会把
这里
之后
1 mov rcx, 870FF5D0531B4286h
这里作为key,add key之后就恢复为之前的块地址,再无条件挑战就行.
同样,模拟执行也可以去除间接分支
去间接分支
我认为其实在执行过程中就能找到真正的执行的,因为key是一样的所以每次得到的地址都是一样的我们只需要把后面的jmp rax 换成真正的地址就能解决.这样也不用管key是静态还是动态的.反正地址是固定的就行.这里我们还是用模拟执行为例
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 """ deobf_ibr_emul.py — 用 Qiling 模拟执行, 取出 -ibr (间接分支) 的真实跳转目标 ================================================================================ 【这是什么】 OLLVM 的 -ibr pass 会把"条件分支"改成: 查加密表 -> +密钥 V 解密 -> jmp rax 这样指令里看不到目标地址, 静态分析(IDA)会在 jmp rax 处断头。 【为什么模拟执行能解】 "藏"只对静态生效: 程序真正执行时, 目标地址一定会被算出来放进寄存器。 所以只要: ① 用 Qiling 把二进制完整模拟跑起来; ② 在每条指令执行【前】hook 一次; ③ 遇到 jmp/call <寄存器> 时, 直接读那个寄存器的值; 拿到的就是"程序自己算出的真实目标"——不需要找密钥 V、不需要解表, 对每次编译随机密钥、甚至动态密钥(MySecret != 0) 都天然免疫。 (顺带记录 'call reg' = -icall 间接调用的目标, 同一个套路。) 【用法】 uniconre/venv/bin/python deobf_ibr_emul.py [选项] 选项: -b, --binary 目标二进制 (默认 ../build/main_ibr) -i, --input 输入文件, 可重复传; 不传则自动跑默认输入组 -f, --force-correct hook 掉 memcmp 强制相等 -> 走 "Correct" 分支 (不需要知道 flag 就能覆盖正确路径) -m, --memcmp-off memcmp 调用的 RVA (默认 0x13e5, 当前 main_ibr 的 间接调用点; 重新编译后需用 objdump 重新确认) -o, --out 输出文件名前缀 (默认 deobf_ibr_emul) 【输出】 控制台 : 每个 (jmp/call reg) 站点 -> 执行到的目标 (均为 RVA) <out>_sites.json : {"站点RVA": ["目标RVA", ...], ...} 【依赖】 Qiling 1.4.6 (uniconre/venv 内已装), capstone, readelf """ import ioimport jsonimport osimport argparsefrom capstone import Cs, CS_ARCH_X86, CS_MODE_64from qiling import QilingHERE = os.path.dirname(os.path.abspath(__file__)) ROOTFS = os.path.join(HERE, "ubuntu24_rootfs" ) DEFAULT_BIN = os.path.abspath(os.path.join(HERE, "../build/main_ibr" )) DEFAULT_MEMCMP_CALL_OFF = 0x13e5 JMP_REGS = set ("rax rbx rcx rdx rsi rdi r8 r9 r10 r11 r12 r13 r14 r15" .split()) md = Cs(CS_ARCH_X86, CS_MODE_64) MAX_INSN_LEN = 15 def run_once (ql, label, lo, hi, out ): """ 用给定的 qiling 实例跑完整个程序, 记录本镜像内所有 jmp/call 寄存器的目标。 参数: ql : 已构造好的 Qiling 实例 (输入已设置) label : 本次运行的说明文字 (用于打印日志) lo,hi : 主镜像的地址范围 [base, end), 只在这范围内 hook, 过滤 libc 噪音 out : 跨多次运行共享的汇总字典 {站点RVA: [目标RVA, ...]} """ sites = {} def hook (ql, addr, size ): """ 指令级探针: 每条指令【执行前】被调用一次 (Qiling/Unicorn 语义)。 三步: ① 范围过滤: (libc/libstdc++ 的每条指令 也会触发回调, 不滤掉会慢一个数量级且结果全是噪音); ② 反汇编: 读当前 PC 处的字节, 用 capstone 解出这一条指令; ③ 识别 + 记录: 若是 "jmp/call <寄存器>", 执行前读该寄存器的值 = 程序刚算出的真实目标 (ibr/icall 隐藏的东西), 记下 (站点->目标)。 """ if not (lo <= addr < hi): return try : code = ql.mem.read(addr, MAX_INSN_LEN) except Exception: return ins = next (md.disasm(code, addr), None ) if ins is None : return if ins.mnemonic in ("jmp" , "call" ) and ins.op_str in JMP_REGS: tgt = getattr (ql.arch.regs, ins.op_str) site = addr - lo tgt -= lo sites.setdefault(site, []).append(tgt) ql.hook_code(hook) ql.run() for s, ts in sites.items(): out.setdefault(s, []).extend(t for t in set (ts)) joined = ", " .join( f"0x{s:x} ->0x{t:x} " for s in sorted (sites) for t in sorted (set (sites[s])) ) print (f" [{label} ] 抓到的点: {joined} " ) def main (): ap = argparse.ArgumentParser( description="Qiling 模拟执行, 取出 -ibr 的真实跳转目标" ) ap.add_argument("-b" , "--binary" , default=DEFAULT_BIN, help ="目标二进制" ) ap.add_argument("-i" , "--input" , action="append" , default=None , help ="输入文件(可重复); 不传则自动跑默认输入组" ) ap.add_argument("-f" , "--force-correct" , action="store_true" , help ="hook memcmp 强制相等, 覆盖 Correct 分支" ) ap.add_argument("-m" , "--memcmp-off" , type =lambda x: int (x, 0 ), default=DEFAULT_MEMCMP_CALL_OFF, help ="memcmp 调用点的 RVA" ) ap.add_argument("-o" , "--out" , default="deobf_ibr_emul" , help ="输出文件名前缀" ) a = ap.parse_args() payloads = [] if a.input : payloads = [(f"输入文件 {p} " , open (p, "rb" ).read()) for p in a.input ] else : payloads.append(("长度错误" , b"x\n" )) payloads.append(("22个A" , b"A" * 22 + b"\n" )) if a.force_correct: payloads.append(("22个A+forceCorrect" , b"A" * 22 + b"\n" )) print (f"目标: {a.binary} " ) all_sites = {} for label, payload in payloads: ql = Qiling([a.binary], ROOTFS, multithread=True , verbose=0 ) ql.os.stdin = io.BytesIO(payload) ql.os.stdout = io.BytesIO() img = next (i for i in ql.loader.images if os.path.basename(i.path) == os.path.basename(a.binary)) lo, hi = img.base, img.end if a.force_correct and "forceCorrect" in label: def force_eq (ql ): ql.arch.regs.rdi = ql.arch.regs.rsi ql.hook_address(force_eq, lo + a.memcmp_off) print (f" 镜像基址={hex (lo)} 范围={hex (lo)} -{hex (hi)} " f"(.text 起始 RVA ≈ 0x10e0)" ) run_once(ql, label, lo, hi, all_sites) print (f" exit={ql.os.exit_code} stdout={ql.os.stdout.getvalue()!r} " ) print () print ("=== 汇总: 所有站点 -> 目标 (RVA) ===" ) for s in sorted (all_sites): print (f" 0x{s:x} -> " + ", " .join( f"0x{t:x} " for t in sorted (set (all_sites[s])))) with open (f"{a.out} _sites.json" , "w" ) as f: json.dump( {f"0x{k:x} " : [f"0x{v:x} " for v in sorted (set (all_sites[k]))] for k in sorted (all_sites)}, f, indent=1 ) print (f"已保存 {a.out} _sites.json" ) if __name__ == "__main__" : main()
这里我们只是先得到了,一个 分支 两种可能的地址.之后我们再patch 修改elf
之后我们patch这样修改
1
2
3
jcc <真目标> ; 条件成立 → 目标A (6字节) jmp <假目标> ; 不成立 → 目标B (5字节) NOP × n ; 抹掉查表链
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 """ patch_from_json.py — 全自动闭环: emul JSON + 静态推导 -> 直接 patch ELF 输入: deobf_ibr_emul.py 输出的 sites JSON (站点RVA -> [目标RVA,...]) 中间: 对每个站点, 从二进制静态推导 patch 所需的两个关键信息: ① 条件语义 : 谁是真目标/假目标 (由 setXX/cmovXX 语义 + 表解密确定) ② 补丁锚点 : 条件标志还活着的位置 (setXX/cmov 指令处) 输出: 补丁后的新 ELF (jcc 真目标; jmp 假目标; 死代码 NOP) 用法: python3 patch_from_json.py <ELF> <sites.json> [输出ELF] """ import subprocess, re, struct, json, sys, osHERE = os.path.dirname(os.path.abspath(__file__)) JCC = {'e' : 0x0f84 , 'ne' : 0x0f85 , 'ge' : 0x0f8d , 'l' : 0x0f8c , 'le' : 0x0f8e , 'g' : 0x0f8f , 'a' : 0x0f87 , 'b' : 0x0f82 , 's' : 0x0f88 , 'ns' : 0x0f89 , 'o' : 0x0f80 , 'no' : 0x0f81 } RX_SET = re.compile (r'set([a-z]{1,3})\s+al' ) RX_CMOV = re.compile (r'cmov([a-z]{1,2})\s+r\w+,\s*r\w+' ) RX_LEA = re.compile (r'lea\s+r\w+,\s*\[rip\s*\+\s*(0x[0-9a-f]+)\]' ) RX_L8 = re.compile (r'mov\s+r\w+,\s*qword \[\s*r\w+\s*\+\s*r\w+\*8(?:\s*\+\s*(0x[0-9a-f]+|\d+))?\]' ) RX_LS = re.compile (r'mov\s+r\w+,\s*qword \[\s*r\w+\s*\+\s*r\w+(?:\s*\+\s*(0x[0-9a-f]+|\d+))?\]' ) RX_SHL = re.compile (r'shl\s+r\w+,\s*(\d+)' ) RX_MOV = re.compile (r'movabs\s+r\w+,\s*(0x[0-9a-f]+)' ) def ripabs (a, s, d ): m = RX_LEA.search(d) return (a + s + int (m.group(1 ), 16 )) & 0xffff if m else None def main (): src, js = sys.argv[1 ], sys.argv[2 ] dst = sys.argv[3 ] if len (sys.argv) > 3 else os.path.join(HERE, '../build/main_ibr_auto_patched' ) emul = {int (k, 16 ): sorted (int (v, 16 ) for v in vs) for k, vs in json.load(open (js)).items()} ro = subprocess.run(['readelf' , '-S' , '-W' , src], capture_output=True , text=True ).stdout tv = toff = dv = dfo = 0 for line in ro.splitlines(): m = re.match (r'\s*\[\s*\d+\]\s+(\.text|\.data)\s+\S+\s+([0-9a-f]+)\s+([0-9a-f]+)' , line) if m: if m.group(1 ) == '.text' : tv, toff = int (m.group(2 ), 16 ), int (m.group(3 ), 16 ) else : dv, dfo = int (m.group(2 ), 16 ), int (m.group(3 ), 16 ) raw = subprocess.run(['r2' , '-q' , '-e' , 'scr.color=0' , '-c' , f'pdj 900 @ {tv} ' , src], capture_output=True , text=True ).stdout insns = [(int (i['addr' ]), int (i['size' ]), (i.get('disasm' ) or i.get('opcode' , '' ))) for i in json.loads(raw)] blob = bytearray (open (src, 'rb' ).read()) def qword (va ): return struct.unpack('<Q' , blob[dfo + (va - dv): dfo + (va - dv) + 8 ])[0 ] n_ok = 0 for site, tgts in sorted (emul.items()): if len (tgts) != 2 : print (f'跳过 0x{site:x} : 目标数={len (tgts)} (非两路 ibr)' ); continue idx = next ((i for i, (a, s, d) in enumerate (insns) if a == site), None ) if idx is None or not re.search(r'jmp\s+r\w+' , insns[idx][2 ]): print (f'跳过 0x{site:x} : 非 jmp reg 站点' ); continue V = mode = jcc = anchor = None off = shl = 0 leas = [] for j in range (idx - 1 , max (idx - 17 , -1 ), -1 ): a, s, d = insns[j] m = RX_MOV.search(d) if m and V is None : V = int (m.group(1 ), 16 ) if anchor is None : m = RX_SET.search(d) if m: jcc, anchor = JCC[m.group(1 )], a else : m = RX_CMOV.search(d) if m: jcc, anchor = JCC[m.group(1 )], a if mode is None : mode = 'cmov' b = ripabs(a, s, d) if b is not None : leas.append(b) if mode is None : m = RX_L8.search(d) if m: mode, off = 'load8' , int (m.group(1 ), 0 ) if m.group(1 ) else 0 else : m = RX_LS.search(d) if m: mode, off = 'shl' , int (m.group(1 ), 0 ) if m.group(1 ) else 0 m = RX_SHL.search(d) if m: shl = int (m.group(1 )) if not (mode and V is not None and anchor is not None and jcc is not None ): print (f'跳过 0x{site:x} : 推导失败(mode={mode} , jcc={jcc} )' ); continue if mode == 'cmov' : if len (leas) < 2 : print (f'跳过 0x{site:x} : cmov 缺基址' ); continue t_f = qword(leas[-2 ]) + V & 0xffffffffffffffff t_t = qword(leas[-1 ]) + V & 0xffffffffffffffff else : if not leas: print (f'跳过 0x{site:x} : 缺表基址' ); continue base = leas[0 ] i0 = off // 8 stride = (1 << shl) // 8 if mode == 'shl' else 1 t_f = qword(base + 8 * i0) + V & 0xffffffffffffffff t_t = qword(base + 8 * (i0 + stride)) + V & 0xffffffffffffffff if sorted ([t_f, t_t]) != tgts: print (f'跳过 0x{site:x} : 推导 {[hex (x) for x in [t_f,t_t]]} != emul {[hex (x) for x in tgts]} ' ); continue if t_f == t_t: print (f'跳过 0x{site:x} : 两目标相同' ); continue end = site + 2 fb = anchor - (tv - toff) n = end - anchor if n < 11 : print (f'跳过 0x{site:x} : 区域太小({n} B)' ); continue blob[fb:fb + 6 ] = struct.pack('>H' , jcc) + struct.pack('<i' , t_t - (anchor + 6 )) blob[fb + 6 :fb + 11 ] = b'\xe9' + struct.pack('<i' , t_f - (anchor + 11 )) blob[fb + 11 :fb + n] = b'\x90' * (n - 11 ) n_ok += 1 print (f'PATCH 0x{site:x} : 锚点0x{anchor:x} jcc->0x{t_t:x} , jmp->0x{t_f:x} , NOPx{n-11 } ' ) open (dst, 'wb' ).write(bytes (blob)) os.chmod(dst, os.stat(src).st_mode) print (f'\n完成: {dst} (成功 {n_ok} /{len (emul)} 站点)' ) if __name__ == '__main__' : main()
icall —— Indirect Call(间接调用)
间接调用,非常常见的一个问题.
其实就是把
改成
这种形式.处理方法其实就和前面的ibr差不多用模拟执行批量处理
fla(控制流平坦化)
个人感觉这应该是最难的一部分,因为他塞了很多东西,我们可以先讲一讲加了fla后cfg的结构
1 2 3 4 5 6 7 8 9 10 11 int foo (int x) { int y; if (x > 10 ) y = x + 1 ; else y = x - 1 ; return y * 2 ; }
CFG是
1 2 3 4 5 6 7 8 9 10 11 12 Entry | x > 10 / \ / \ A B y = x+1 y = x-1 \ / \ / C return
而平坦化之后, 会带来一个dispatcher(分发器)
他会把你的结构变成
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 Prologue | state = STATE_ENTRY | v +-------------+ | Dispatcher | +------+------+ | +---------+---------+ | | | v v v A B C | | | | | | 改 state 改 state return | | +----+----+ | v Dispatcher
这里更改state 后其实就是会根据a 之后是什么又跳到其他 块,这就是一个状态的形式了
前面只是一个引入.后面我们来了解一下控制流平坦化后的组成
序言块:函数入口那部分块
状态变量:你可以看作 switch(state)的操控case到哪里的值
主分发器:控制真实块的执行路径
真实块:原本的业务逻辑
不过你需要注意.原先的业务逻辑块一般有三种情况
比如对于一个块A,他的后继,也决定了复杂程度
没有后继块,就直接retn了
有1个后继块:A-> B,把state 修改成B对应的case 的value就行
有两个后继块,对应条件跳转.
预分发块
jmp回分发器
Return Block
程序退出
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 """ qiling_fla_encrypt.py —— 用 Qiling 模拟执行,去除 TEA::encrypt 的控制流平坦化(FLA) 目标: tea/build/main_fla (OLLVM -fla 混淆的 C++ TEA 程序) FLA 把函数摊成状态机: 真实块 D --(写下一个状态 S')--> 跳回分发器 --> 分发器读状态 S --> 跳到块 D(S) 所以"藏"的不是"执行了哪些块",而是"块与块之间的先后/依赖关系(CFG)"。 本脚本思路(3 步): ① 在分发器头读状态槽 -> 得到当前状态 S,记下"上一个真实块写出的下一个状态就是 S" -> b2s[prev].add(S) ② 在分发器比较链里找"K == S"的那条 sub/cmp $K; je D -> 状态 S 分派到真实块 D -> s2b[S].add(D) ③ 合成: 块 B 的后继 = { s2b[S'] for S' in b2s[B] },即真实 CFG TEA::encrypt 的循环自然覆盖两条出边(i<64 进循环体 / i>=64 退出),所以单次运行即可还原。 用法: /home/f0x/anaconda3/envs/frida/bin/python qiling_fla_encrypt.py (或任何装了 qiling + capstone 的 python) """ import ioimport osfrom capstone import Cs, CS_ARCH_X86, CS_MODE_64from qiling import QilingHERE = os.path.dirname(os.path.abspath(__file__)) BIN = os.path.abspath(os.path.join(HERE, "../build/main_fla" )) ROOTFS = os.path.join(HERE, "ubuntu24_rootfs" ) ENC_BASE = 0x1590 ENC_NEXT = 0x1780 ENC_SLOT = -0x44 ENC_HEAD = 0x15ec COND_JUMPS = {"je" ,"jne" ,"jz" ,"jnz" ,"jg" ,"jge" ,"jl" ,"jle" , "ja" ,"jae" ,"jb" ,"jbe" ,"js" ,"jns" ,"jo" ,"jno" ,"jp" ,"jnp" ,"jc" ,"jnc" } md = Cs(CS_ARCH_X86, CS_MODE_64) MAX_INSN = 15 def parse_last_imm (op_str ): """从 'eax, 0x327b23c6' 取最后一个立即数(int),取不到返回 None""" tok = op_str.split("," )[-1 ].strip() try : return int (tok, 0 ) if tok.lower().startswith("0x" ) else int (tok, 16 ) except ValueError: return None def parse_jump_target (op_str ): """从 '0x1659' 取跳转目标(int)""" tok = op_str.strip() try : return int (tok, 0 ) if tok.lower().startswith("0x" ) else int (tok, 16 ) except ValueError: return None def main (): ql = Qiling([BIN], ROOTFS, multithread=True , verbose=0 ) ql.os.stdin = io.BytesIO(b"A" * 22 + b"\n" ) ql.os.stdout = io.BytesIO() base = ql.loader.load_address head_abs = base + ENC_HEAD entry_abs = base + ENC_BASE end_abs = base + ENC_NEXT state = {"cur_block" : None , "waiting" : False , "comparing_k" : None , "pending_state" : None , "rbp" : 0 } s2b = {} b2s = {} def on_code (ql, addr, size ): if not (entry_abs <= addr < end_abs): return rva = addr - base if addr == entry_abs: state["cur_block" ] = None state["waiting" ] = False state["comparing_k" ] = None return if addr == head_abs: state["rbp" ] = ql.arch.regs.rbp S = int .from_bytes(ql.mem.read(state["rbp" ] + ENC_SLOT, 4 ), "little" ) prev = state["cur_block" ] if prev is not None : b2s.setdefault(prev, set ()).add(S) state["pending_state" ] = S state["waiting" ] = True state["comparing_k" ] = None state["cur_block" ] = None return if not state["waiting" ]: return ins = next (md.disasm(ql.mem.read(addr, MAX_INSN), addr), None ) if ins is None : return if ins.mnemonic in ("sub" , "cmp" ): k = parse_last_imm(ins.op_str) if k is not None : state["comparing_k" ] = k return if ins.mnemonic in COND_JUMPS: if state["comparing_k" ] == state["pending_state" ]: tgt = parse_jump_target(ins.op_str) if tgt is not None : blk = tgt - base state["waiting" ] = False state["cur_block" ] = blk s2b.setdefault(state["pending_state" ], set ()).add(blk) return ql.hook_code(on_code) ql.run() print (f"镜像基址 = {hex (base)} \n" ) print ("== 分发表: 状态常量 -> 真实块 ==" ) for s in sorted (s2b): print (f" 0x{s:08x} -> " + ", " .join(f"0x{b:x} " for b in sorted (s2b[s]))) print ("\n== 块转移: 真实块 -> 写出的下一个状态 ==" ) for b in sorted (b2s): print (f" 0x{b:x} -> " + ", " .join(f"0x{s:08x} " for s in sorted (b2s[b]))) cfg = {} for b, states in b2s.items(): succ = set () for s in states: succ.update(s2b.get(s, set ())) cfg[b] = sorted (succ) print ("\n== 还原出的真实控制流(CFG) ==" ) print (" 入口(白化+sum=0+i=0) -> 0x1640(循环判断)" ) for b in sorted (cfg): succ = cfg[b] label = {0x1640 : "循环判断 i<64" , 0x1659 : "轮主体 sum+=DELTA,mix" , 0x175d : "i++" , 0x1772 : "返回" }.get(b, "?" ) if succ: print (f" 0x{b:x} ({label} ) -> " + ", " .join(f"0x{x:x} " for x in succ)) else : print (f" 0x{b:x} ({label} ) -> (返回)" ) print ("\n== 对应源码 tea.cpp 的 encrypt ==" ) print (" v0^=k0^k3; v1^=k1^k2; sum=0; // 入口白化" ) print (" for(i=0;i<64;i++){ // 0x1640 循环判断" ) print (" sum+=DELTA; v0+=mix; v1+=mix; // 0x1659 轮主体" ) print (" } // 0x175d i++ 回到判断" ) print (" return; // 0x1772" ) if __name__ == "__main__" : main()
这里我们只对encrypt做了恢复,具体流程见代码和注释,还是比较好理解的.
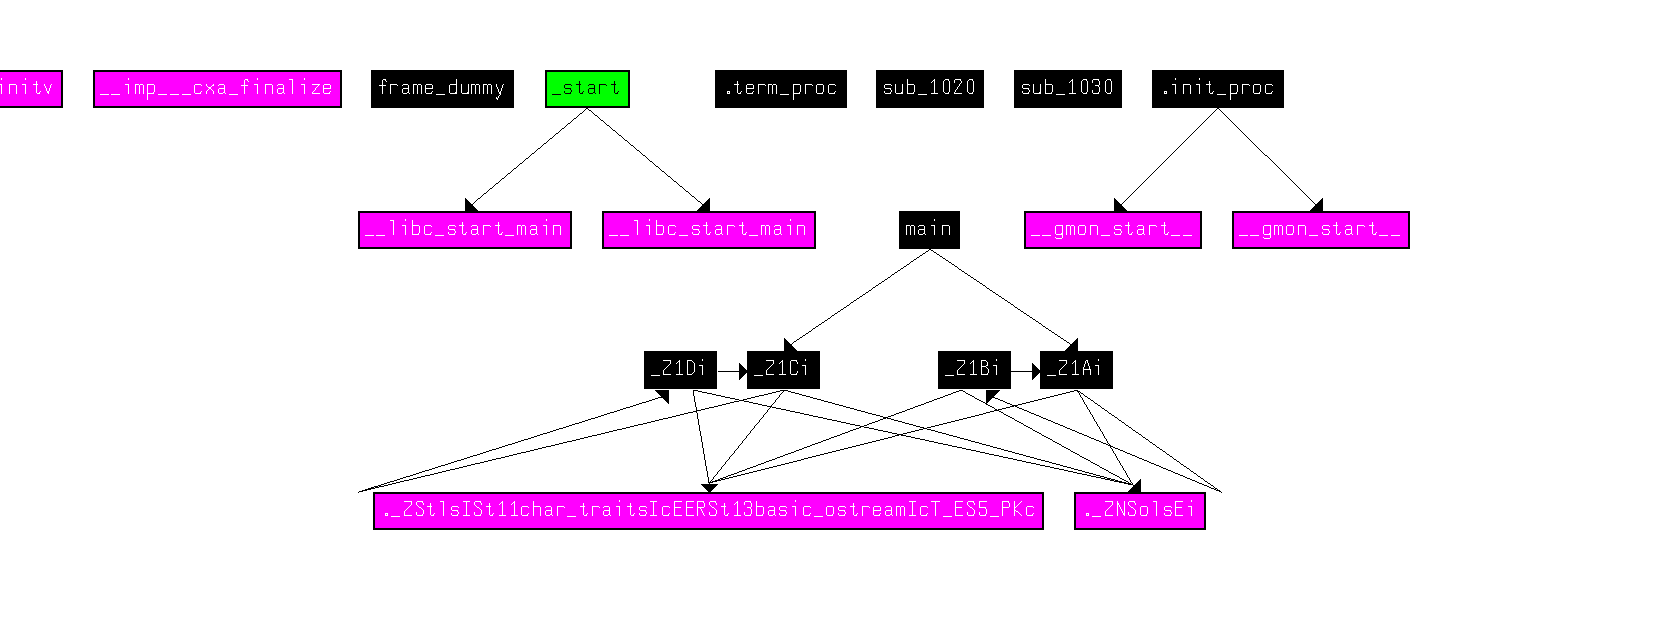 这是ida的图的可能有点难看,就是这样
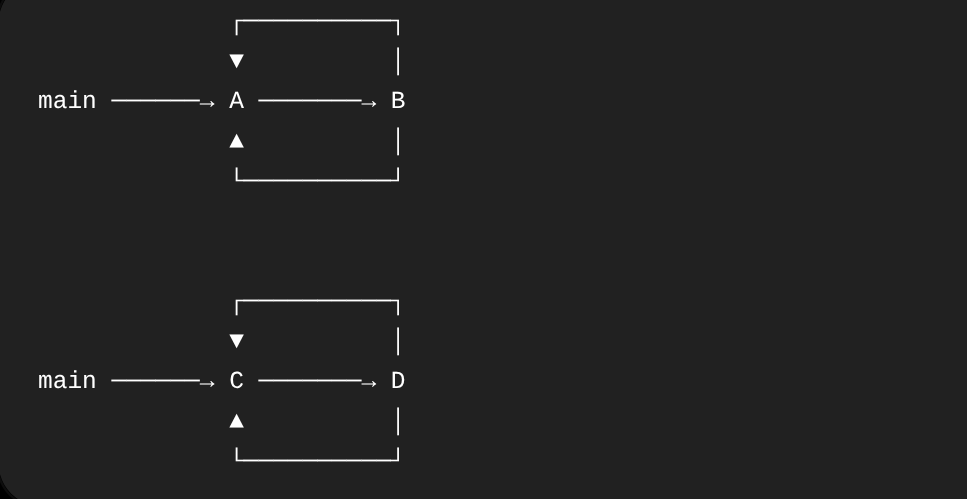 所以这里构成了两个循环,
有向图中一个尽可能大的节点集合,其中任意两个节点都能够互相到达。
因此强连通分量划分是:
 混淆后,这里之加入了1级
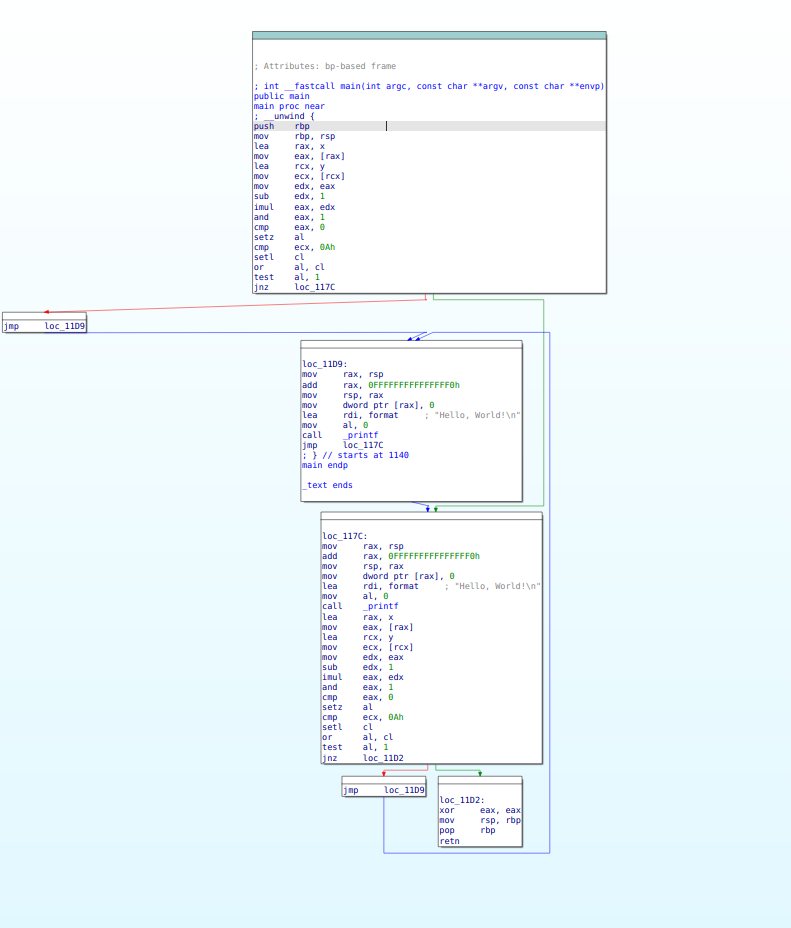 就变成了这样
这里因为体量比较小,如果体量较大的话.会导致文件体量膨胀,毕竟把一个块增生了很多东西
可以看看他的结构是怎样的,让ai翻译了一下注释
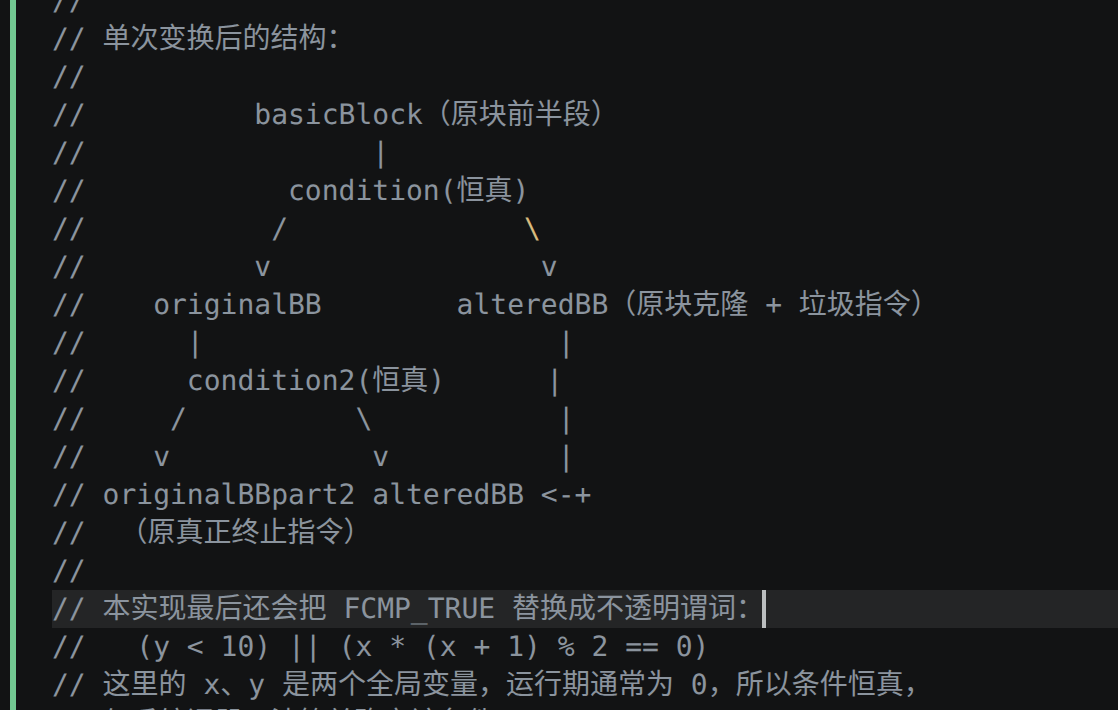 虚假控制流的操作单位是基本块
他的实际执行流程是basicBlock->originalBB->originalBBpart2
原理其实非常简单.正如我们前面所说的写一个恒真的条件然后跳转到我们制定的位置.差不多就是这样.
重点在与如何绕过呢
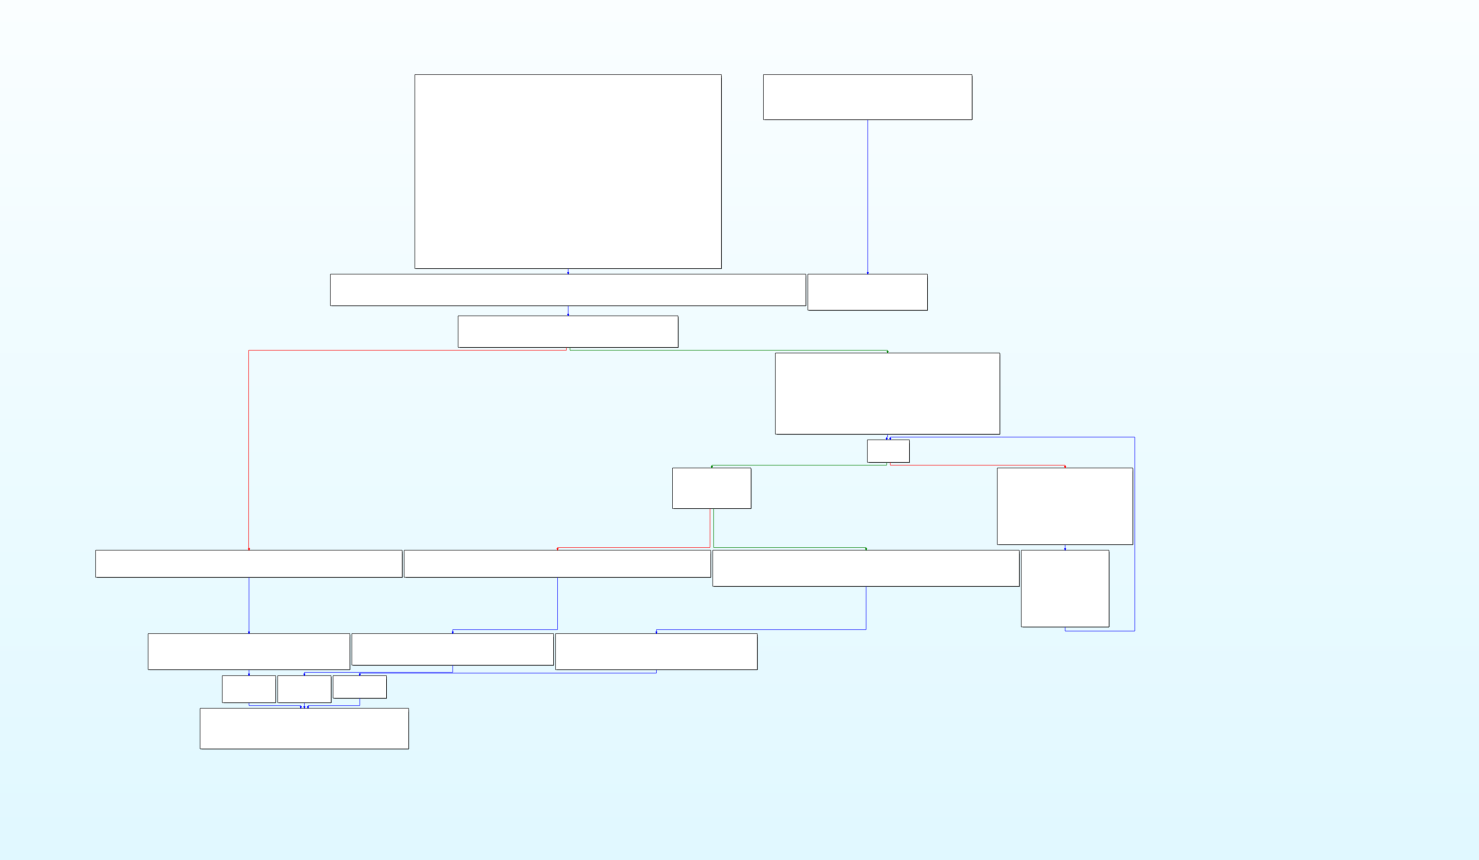
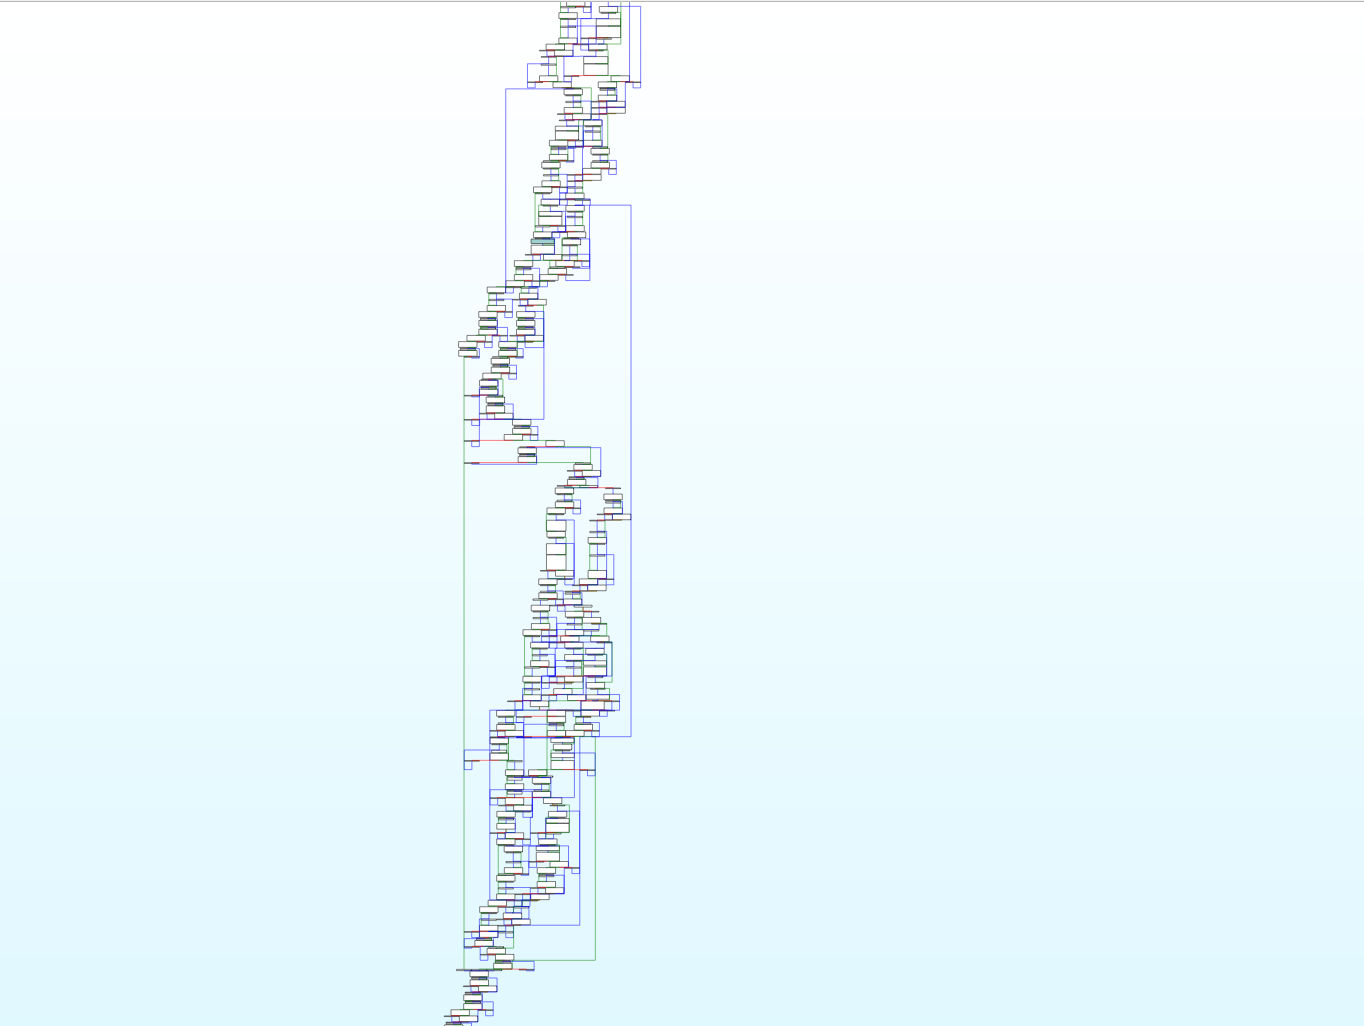 ok现在变成大粪了.之后我们试试这些方法
 比如这里.就是unk_406存放明文, &unk_2054是密文+key,调用解密函数sub_14C0进行解密,之后再输出解密函数如下
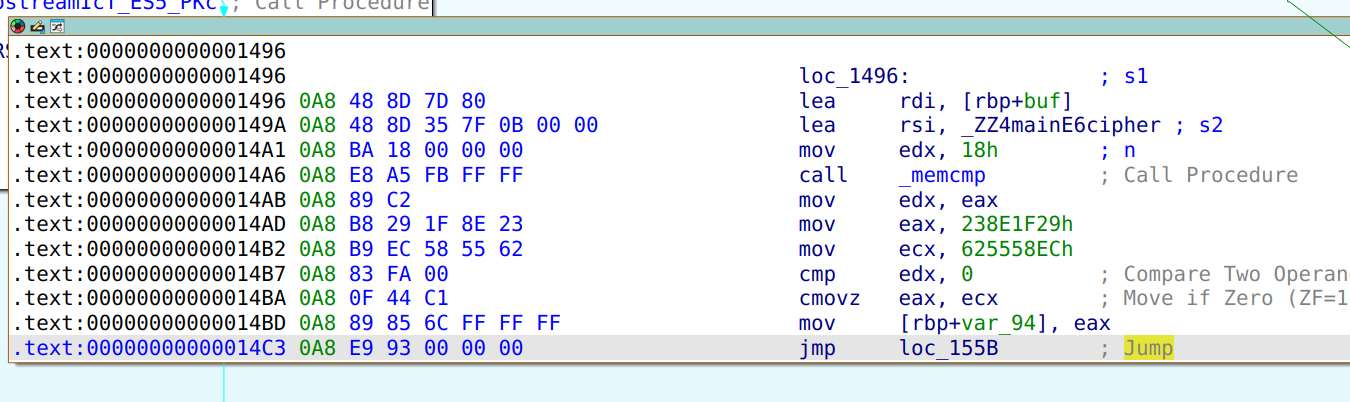
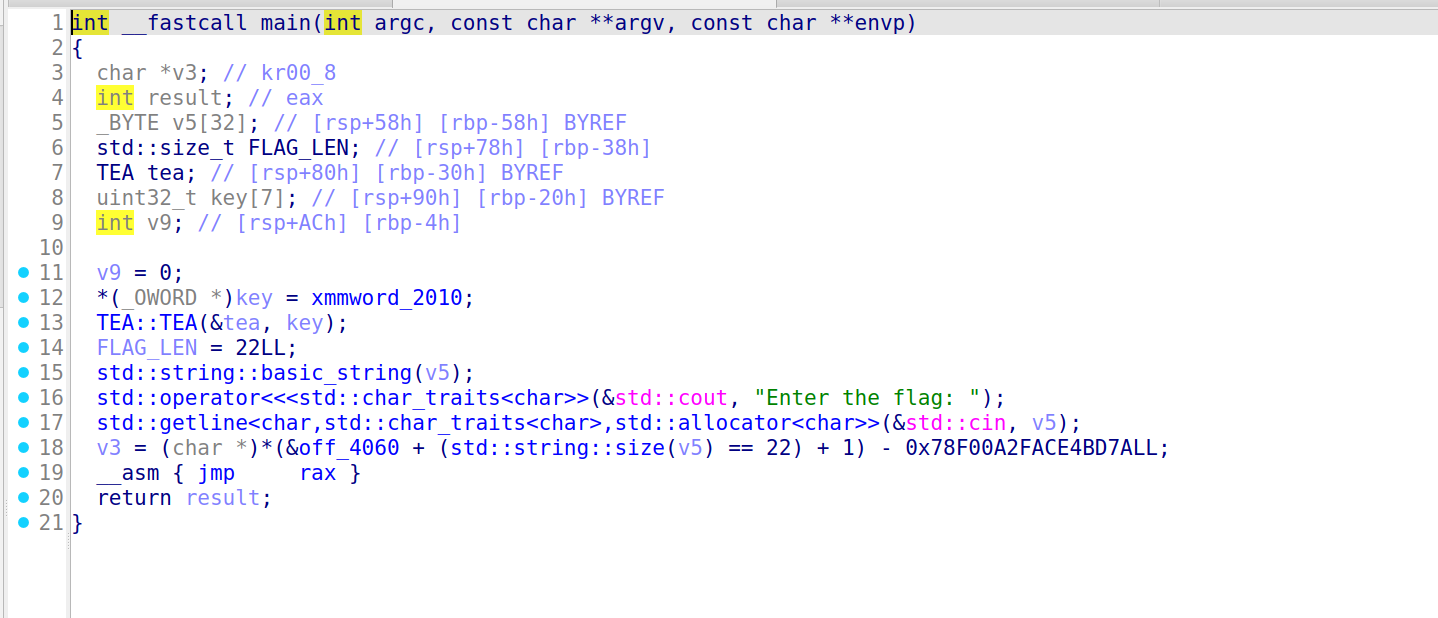 比如遇到了类似与这种与到了条件跳转比如jz之类的指令就会有两个分支或者多个分支
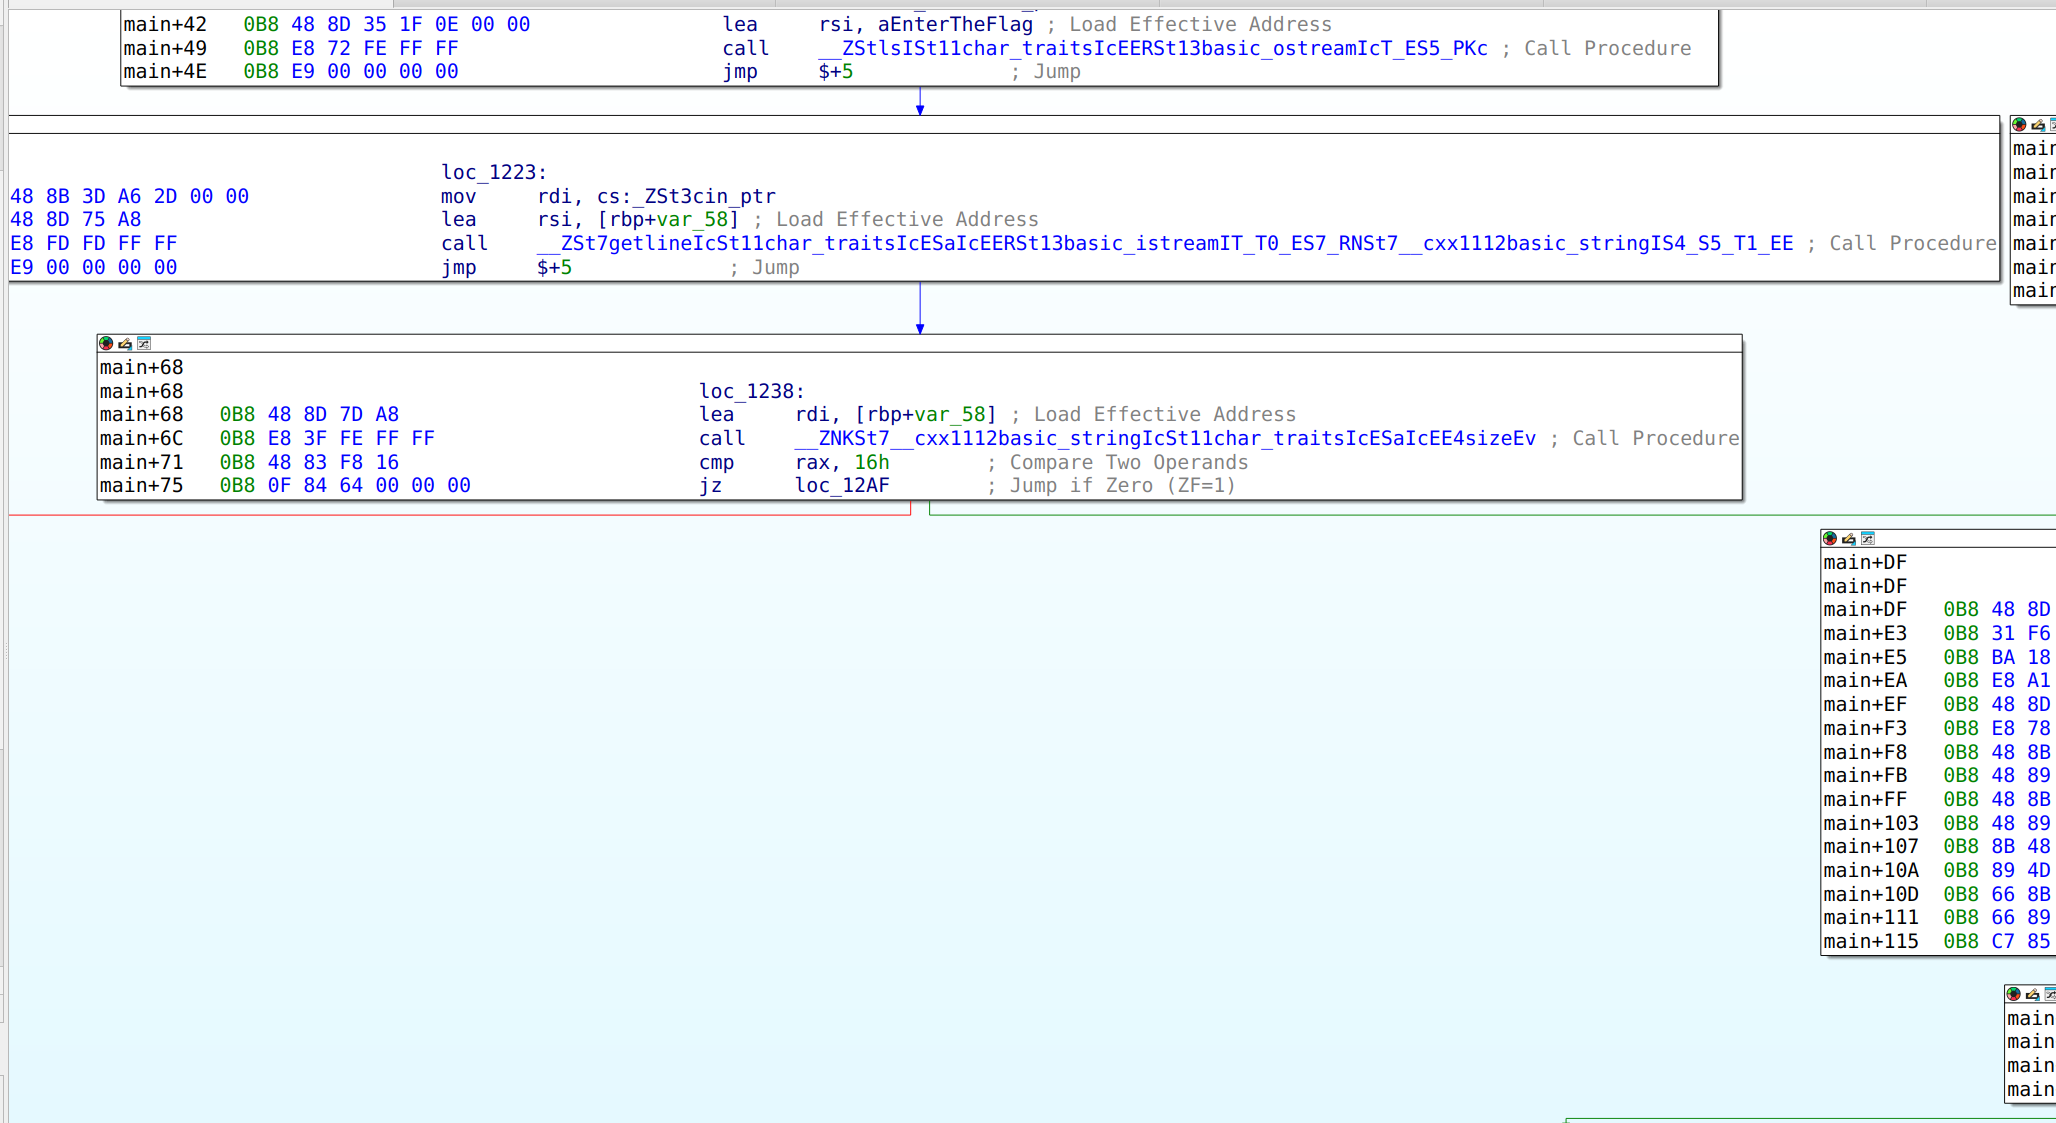 就会被把跳转的块记录为在表中并加密.
之后就变成了这样
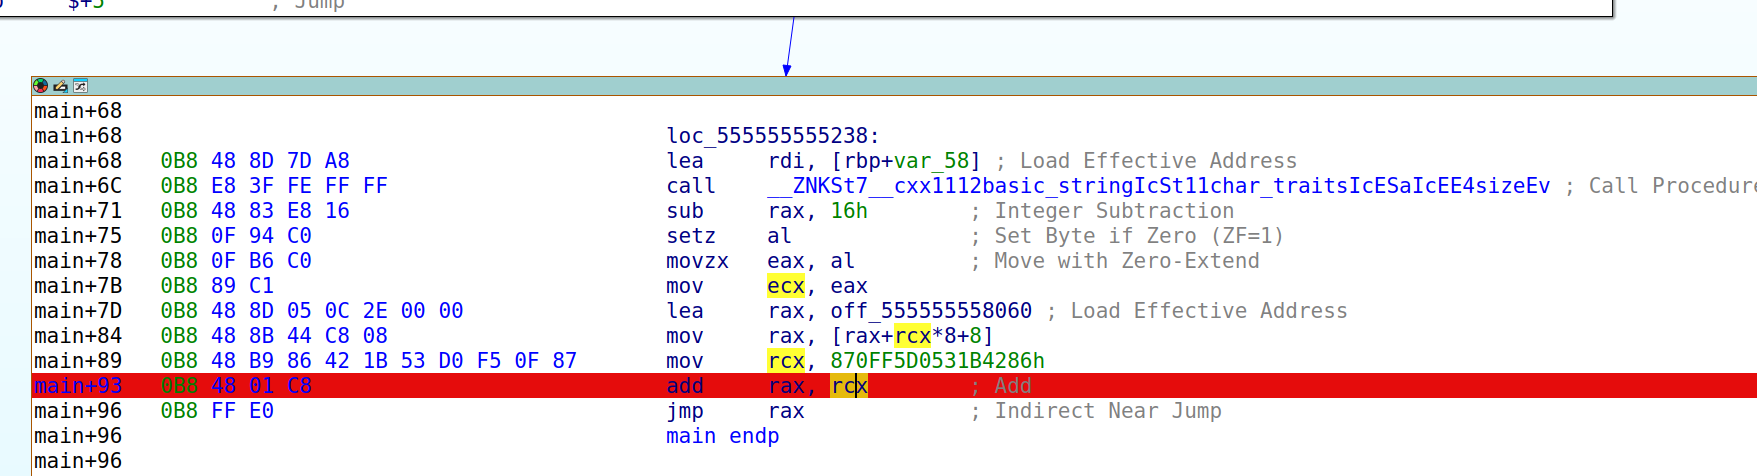 rcx控制跳转哪个块,作为偏移,在
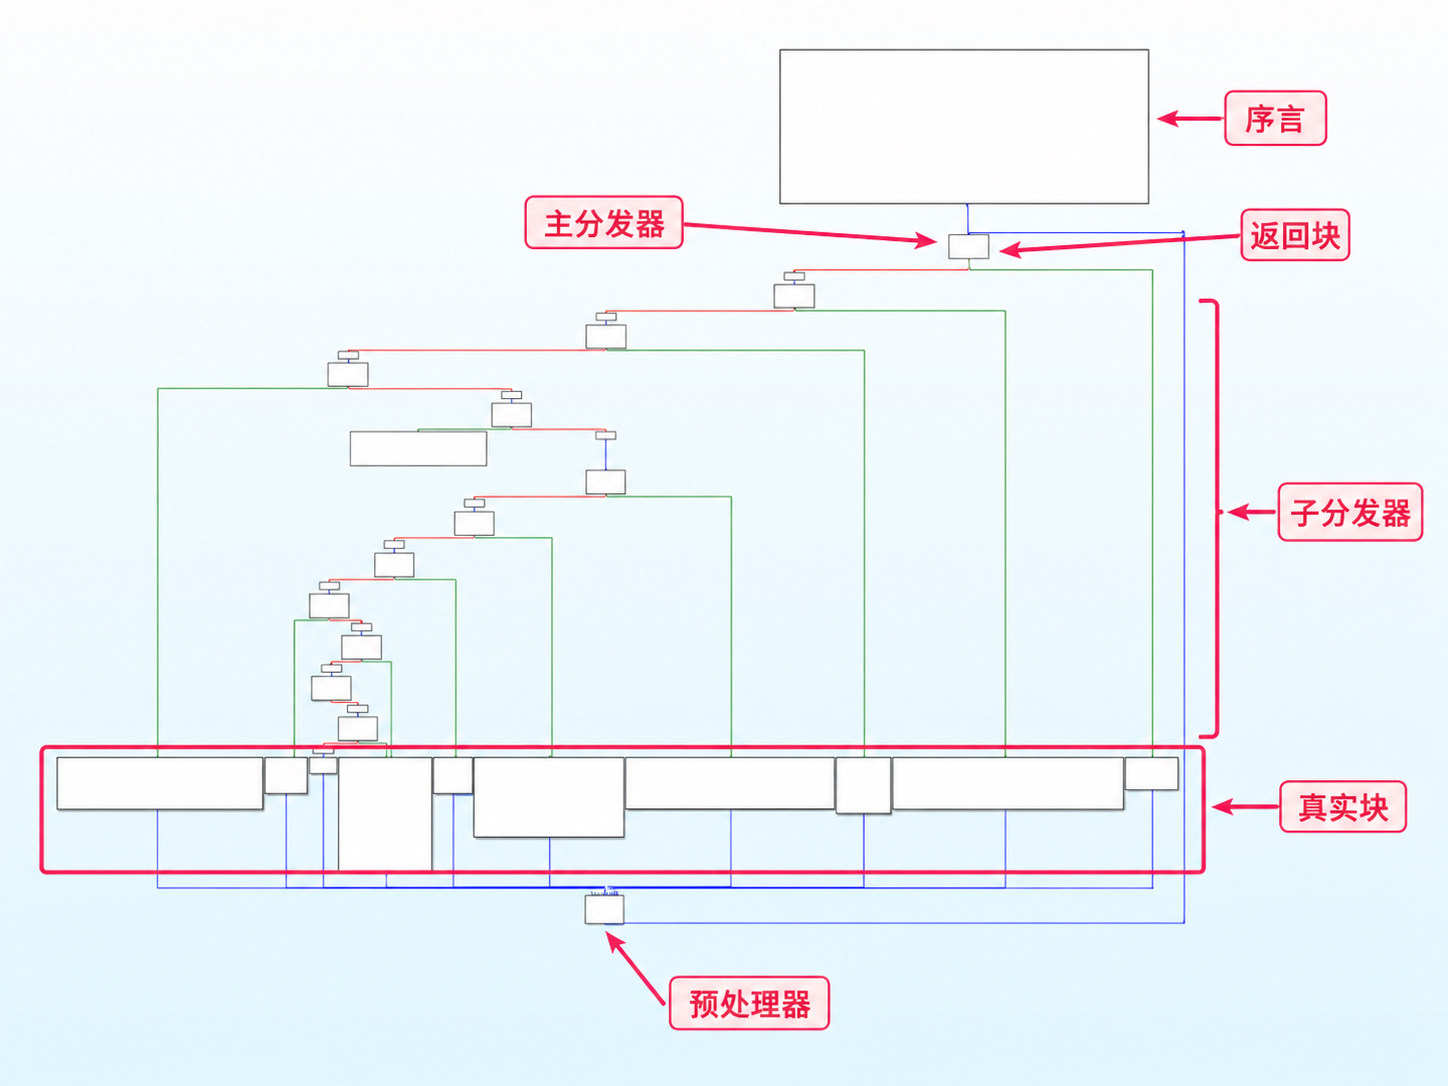 ok上面的图相信能够看出被混淆后大概的结构,原本的我们也只有真实块这部分
控制流平坦化其实就是把 原来的
比如
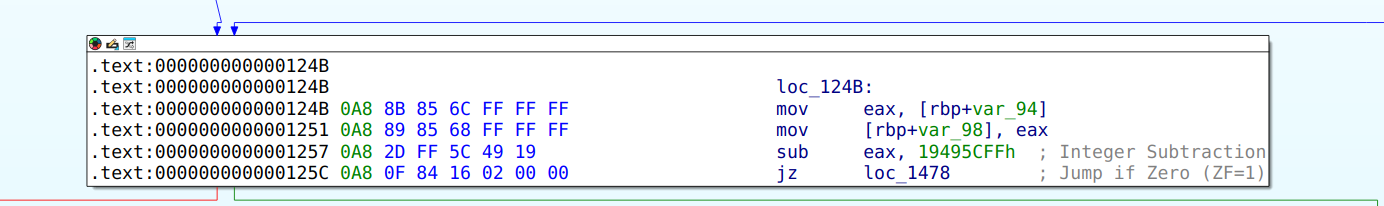 比如这里,他会根据判断,一步步往下走,也就是下面的子分发器.不过其实我觉得就是一步步往下推 用sub eax case_value来判断,是就到对应的块,不是就继续往下执行.
 这里就根据判断选择 value就行,实现的话就用select